阶段 11 讲义 — Agent 安全的四层防线
阶段 11 讲义 — Agent 安全的四层防线
本阶段的核心命题
Agent 的风险来自"模型可以行动",而不只是"模型可能答错"。
一个会答错的问答系统,损失是一次错误信息;一个会行动的 Agent,损失是一笔真实发生的交易、一次真实泄露的数据。这一层的产品定义比任何交互设计都重要。
一、威胁地图:Agent 时代的攻击面
OWASP 在 2025-12 发布了 Top 10 for Agentic Applications(2026 版),编号 ASI01–ASI10。完整十条,每条都对应了真实发生过的事件:
| 编号 | 风险 | 说明 | 官方举的真实案例 |
|---|
| ASI01 | 目标劫持(Agent Goal Hijack) | 通过注入内容改变 Agent 的目标或计划——Agent 版的间接提示词注入 | EchoLeak |
| ASI02 | 工具滥用(Tool Misuse) | 把合法工具用出破坏性结果:不安全链式调用、含糊指令、被操纵的工具输出 | Amazon Q |
| ASI03 | 身份与权限滥用(Identity & Privilege Abuse) | 利用被委派的信任、泄漏的凭据、角色链,做超出授权范围的事 | — |
| ASI04 | 智能体供应链漏洞(Agentic Supply Chain Vulnerabilities) | 被篡改的第三方 Agent、工具、插件、注册表、更新通道;MCP / A2A 这类动态生态尤其暴露 | GitHub MCP exploit |
| ASI05 | 意外代码执行(Unexpected Code Execution) | 自然语言路径被打通成远程代码执行 | AutoGPT RCE |
| ASI06 | 记忆与上下文投毒(Memory & Context Poisoning) | 污染长期记忆,在初次交互很久之后仍持续改变行为 | Gemini Memory Attack |
四条最值得产品经理记住的
- ASI01 的载体通常不是用户输入,是 Agent 读到的网页、文档、邮件、工具返回。用户可能完全无辜。
- ASI03 的根源常常是"图省事":给 Agent 一个高权限服务账号,比给每个用户做权限透传简单得多——然后越权就变成了默认状态。
- ASI06 的危害在于持久性:一次成功的投毒,影响之后的每一次会话,且看起来完全正常。
- ASI09 是唯一一条攻击面在人身上的。它直接否定了"加个确认框就安全了"——如果 Agent 给出的理由足够漂亮,人会照批。这条是本讲义第五节"预览要用业务语言、要说清不可逆后果"的根据:确认界面的设计本身是一项安全控制。
Skills 生态另有一份清单
OWASP 还维护着一份独立的 Agentic Skills Top 10(AST01–AST10),专门覆盖技能包的风险(例如 AST09「无治理」——技能被个人随手安装,没有清单、没有审批、没有审计轨迹)。做 Skill 体系时对照它,不要和 ASI 混用编号。本仓 .claude/skills/ 有 35+ 个技能,正好可以拿这份清单做一次自查。
二、提示词注入:为什么"过滤"不管用
直接注入:用户在输入里写"忽略之前的指令"。
间接注入:攻击指令藏在 Agent 会读到的内容里——网页正文、PDF、邮件、代码注释、数据库字段、甚至工具返回的错误信息。
为什么"加个过滤器"不是解法:业界常见的"AI 防火墙"思路——在 Agent 和外部世界之间放一个分类器,判断输入是不是恶意注入——对成熟攻击基本无效。OpenAI 在其抗注入设计的说明中明确指出了这一点。原因不难理解:注入是自然语言,分类器要在无限的表达空间里划一条线,攻击者只要绕过一次就成功。
有效的方向是设计层面的:
| 思路 | 做法 |
|---|
| 能力隔离 | 让 Agent 根本没有做危险事的能力,而不是"劝它别做" |
| 数据/指令分离 | 从架构上把不可信内容标记为数据,让它无法影响控制流。学术上的代表是 CaMeL(arXiv:2503.18813)—— 用一个受信任的解释器隔离数据流与控制流 |
| 最小权限 + 逐动作授权 | 危险动作需要独立的、不可被内容影响的授权路径 |
| 人在关键点确认 | 不可撤销动作必须有人签字 |
产品经理该记住的一句话
"让模型不被骗"是做不到的;"就算被骗也做不成坏事"是做得到的。 所有安全设计资源应当投在后者。
三、四层防线
一个可用的 Agent 安全体系应当是纵深的,而不是单点的:
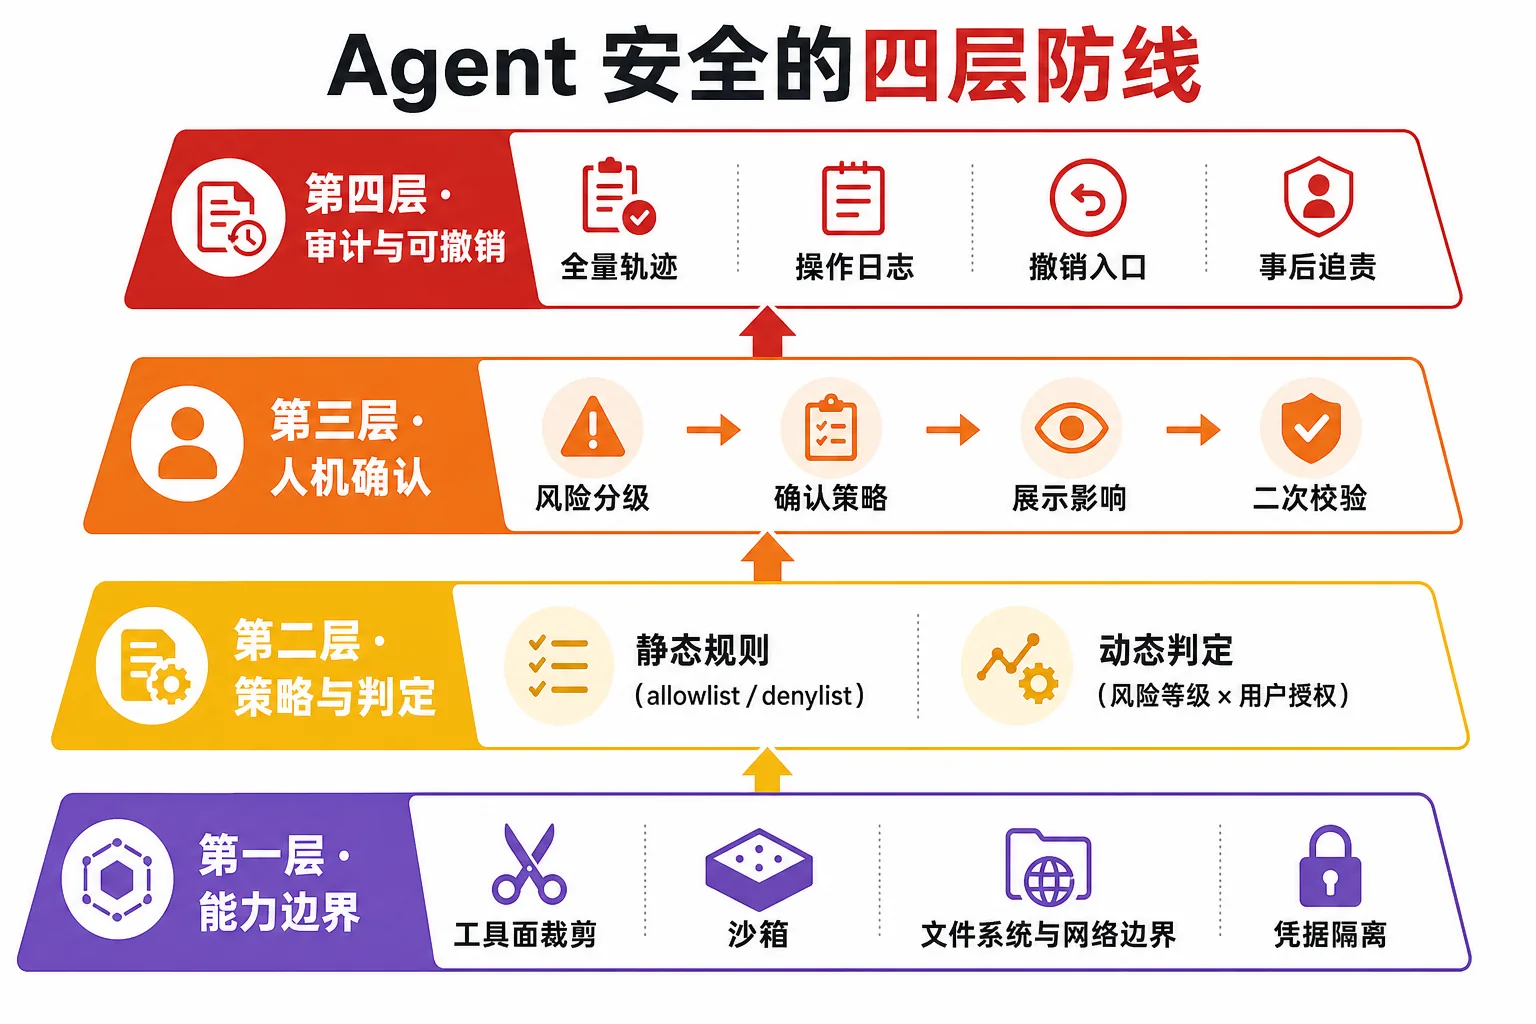
第一层:能力边界(最有效,也最便宜)
| 边界 | 手段 |
|---|
| 工具面 | 按会话/用户/场景只暴露必要工具 |
| 文件系统 | 限定可读可写目录 |
| 网络 | 出站白名单;禁止 Agent 访问内网元数据服务 |
| 进程/代码执行 | 沙箱(成本见阶段 6:Windows ≈ macOS 的 20 倍工作量) |
| 凭据 | Agent 不持有长期高权限凭据;用户权限透传而不是服务账号 |
第二层:策略与判定
静态规则便宜、可预期、可审计,应当承担绝大部分判定。模型判官用于静态规则表达不了的语义判断。
权限优先级本身就是安全政策
权限系统不能只列出 Allow / Ask / Deny,还要定义谁先判断。推荐的不变量是:
- deny 先于所有自动放行模式;
- Schema 和业务输入无效时直接拒绝,不弹确认;
- 用户临时批准不自动升级为长期授权;
- Bypass 模式仍保留免疫清单:用户明确要求询问的动作、必须真人输入的动作、可获得持久执行能力的配置修改;
- 语义分类器无法收敛时回退人工,而不是无限模型互判。
Allow 规则本身可能等于任意代码执行
例如允许宽泛的 Shell、Python 或包管理器前缀,可能让 Agent 间接执行任意代码。规则评审必须分析“这条规则最终能组合出什么能力”,而不只看命令名字。
权限与 Sandbox 是两个正交控制
| 控制 | 回答的问题 | 失效后的风险 |
|---|
| 权限 | 这次动作是否允许做 | 未授权动作被执行 |
| Sandbox | 即使允许,最多能影响到哪里 | 合法工具造成过大影响范围 |
Claude Code 的案例采用权限规则、Hooks 与独立 Sandbox Runtime 叠加。基础教程应迁移职责边界,不把具体模式数量或平台实现写成永久契约。详见 Claude Code:权限模型。
Codex 的 Guardian 是目前公开可读的最完整案例,两个设计点值得抄:
- 二维判定:风险等级 × 用户授权,而不是单一的"允许/拒绝"
- 策略文件里一半篇幅在防误报
只优化"漏拦"的安全设计会被用户关掉
安全组件有两个失败方向:漏拦(危险)与误拦(不可用)。只盯前者,最终产物是一个每三步弹一次窗、用户第一件事就是找开关关掉它的系统——那时安全等级是零。误报率是安全组件的一等指标。
第三层:人机确认
见下一节。
第四层:审计与可撤销
- 全量轨迹:谁、什么时候、以什么身份、做了什么、依据是什么
- 可撤销:能撤的动作提供撤销入口,并明确撤销窗口
- 不可撤销的动作要在执行前说清楚不可撤销
四、风险分级与授权矩阵
这是本阶段最重要的产品交付物。
动作分级(推荐四级)
| 级别 | 特征 | 授权方式 |
|---|
| L0 只读 | 无副作用,数据非敏感 | 自动执行 |
| L1 可撤销写 | 有副作用但能撤销(草稿、占座、标记) | 自动执行 + 事后可见可撤销 |
| L2 不可撤销写 | 发消息、提交订单、修改配置 | 每次确认,展示影响 |
| L3 高危 | 资金、退款、删除、权限变更、外发数据 | 确认 + 二次校验 + 审计 + 可能需要双人 |
别把这套分级和「自主等级」混为一谈——它们是两个正交的轴
上表分的是动作的风险(这件事做错了有多严重)。云安全联盟(CSA)那套六级分的是系统的自主度(人参与到什么程度),刻意对标了自动驾驶的 SAE J3016 分级:
| 级别 | 名称 | 决策者 | 执行者 | 人的参与 |
|---|
| L0 | 无自主(No Autonomy) | 人 | 人 | 每个动作 |
| L1 | 辅助(Assisted) | 人 | AI | 逐动作审批 |
| L2 | 受监督(Supervised) | 人 | AI | 审批计划/批次,之后自动执行 |
| L3 | 有条件(Conditional) |
授权矩阵模板
| 工具 | 级别 | 谁能用 | 确认方式 | 展示什么 | 可撤销 | 审计字段 |
|---|
| search_flights | L0 | 全部 | 无 | — | — | 调用次数 |
| hold_seat | L1 | 登录用户 | 无(但可见可撤销) | 占座卡片 | 是,X 分钟内 | 用户/航班/时间 |
| create_order | L2 | 登录用户 | 每次 | 航班、价格、乘客、退改规则 | 有条件 | 全量 |
|
只读工具也有风险
search_flights 是 L0,但它返回的内容是注入的载体。所以只读工具的风险不在"它做了什么",在"它带回了什么"。对策:工具返回内容要标注为不可信数据、结构化字段优于自由文本、外部内容不参与控制流判断。
人在环内 vs 人在环上
| Human-in-the-loop | Human-on-the-loop |
|---|
| 形态 | 每个关键步骤确认 | 事后监督 + 可随时干预 |
| 适用 | L2/L3 动作、低频高价值 | L0/L1、高频 |
| 成本 | 高(人的时间是瓶颈) | 低 |
| 风险 | 确认疲劳导致无脑点"是" | 发现时可能已经晚了 |
确认疲劳是真实的失效模式
弹窗太多,用户会形成"看到就点确认"的肌肉记忆——这时确认框的安全价值等于零,但你以为它还在。所以确认必须稀缺:把 L0/L1 做成自动 + 可撤销,把确认预算全部留给 L2/L3。
五、交互模式:预览 → 确认 → 执行 → 回执 → 撤销
一个成熟的高风险动作交互,有五个环节:
| 环节 | 要点 |
|---|
| 预览(Dry-run) | 说清将要发生什么、影响什么、花多少钱。用业务语言,不是参数列表 |
| 确认 | 确认动作要与风险等级匹配(点按钮 / 输入关键信息 / 二次验证) |
| 执行 | 有进度;不可中断的部分要说明 |
| 回执 | 做了什么、结果如何、单号是什么、下一步能做什么 |
| 撤销 | 可撤销的给入口和时限;不可撤销的在确认前就说清楚 |
预览是最被低估的一环
它同时解决三个问题:让用户有控制感、让错误在发生前被发现、让 Agent 的意图变得可审计。很多"Agent 不敢用"的心理障碍,一个好的预览就能消除大半。
六、Hooks 的信任边界
Hook 可以阻止或改写工具调用、参与权限判断、注入上下文和发送 HTTP 请求,因此项目级 Hook 本质上是代码执行与数据外发能力。
最低治理要求:
- 项目级 Hook 经过工作区信任门;
- HTTP Hook 只能引用白名单环境变量;
- 不同生命周期设置不同超时,退出 Hook 不与构建 Hook 共用默认值;
- 非阻塞失败也要限频和打点,避免每次调用都向上下文注入错误;
- 配置 Schema 往返读写必须验证字段不被 Transform 静默丢失;
- 无 UI 的 Subagent 无法完成人工审批时应 Fail-closed。
完整案例见 Claude Code:Hooks 治理层。
七、Fail-open 与 Fail-closed
规则:安全组件必须 fail-closed。
| 组件 | 挂了怎么办 |
|---|
| 权限校验服务 | 拒绝(不是放行) |
| 风险判定模型 | 降级到静态规则的最严档(不是跳过) |
| 审计日志 | 写不进去就不执行高危动作 |
| 沙箱不可用 | 配置为 Fail-closed:禁用需要沙箱的工具(不要假设所有 Harness 默认如此) |
阶段 9 实践 4 已经在编排层建立过这个直觉(审核 Subagent 失败不能默认通过),这里是它的系统化表述。dsh 的"fail-closed 四层防线"是本仓可对照的完整实现(dsh 第 10 章)。
八、身份与授权:两种模式要分清
| 模式 | 含义 | 风险 |
|---|
| 代表用户行动(On-behalf-of) | Agent 使用用户的权限 | 权限透传复杂,但边界清晰 |
| Agent 自身身份(Agent identity) | Agent 有自己的服务账号 | 简单,但极易越权——它的权限往往是所有用户权限的并集 |
产品原则:默认走 on-behalf-of。用服务账号时必须回答:"如果这个 Agent 被诱导,它能碰到多少不属于当前用户的数据?"
本仓已有 Agent 授权的两种模式 专门讲这个。另外,Codex 已经在为"Agent 作为独立主体"铺基础设施(密码学身份 + 工作负载身份),这是行业方向,但不改变"当前应当默认最小权限"这一判断。
九、常见误区清单
| 误区 | 纠正 |
|---|
| "加个内容过滤器就能挡住注入" | 对成熟攻击基本无效;要靠能力隔离与数据/指令分离 |
| "弹个确认框就安全了" | 弹窗是 UI;安全是能力边界。且确认疲劳会让它失效 |
| "只读工具没风险" | 它带回的内容是注入的主要载体 |
| "用服务账号方便" | 它的权限是所有用户的并集 |
| "安全组件挂了先放行保可用" | 安全必须 fail-closed |
| "误报多点没关系,安全第一" | 误报多到一定程度,用户会关掉它 |
| "记忆里的东西是我们自己写的" | 记忆可被投毒(ASI06),要有写入门槛与来源标注 |
| "沙箱是研发的事" | 平台成本差异直接影响支持哪些平台 |
| "开了 Bypass 就什么都能绕过" | 高风险模式仍需免疫清单和远程止血 |
| "Hook 失败不阻塞就没风险" | 失败仍可能污染上下文、日志或触发数据外发 |
十、外部一手资料(阶段 11 精读,约 5 小时)
本仓已有资料:
- dsh:fail-closed 的四层防线
- Codex:从静态规则到模型判官
- Codex:四个操作系统四套沙箱
- 抵抗 Prompt Injection
- Agent 授权的两种模式
- 可信 Agent 实践
- 如何监控内部编码 Agent
- Claude Code:权限与 Sandbox
- Claude Code:Hooks 治理
把 Codex 与 Claude Code 放在一起读
Codex 展示以 OS 隔离和 Guardian 为中心的纵深安全;Claude Code 展示权限规则、Hooks 与外部 Sandbox Runtime 的组合。重点不是评谁更安全,而是识别两者的威胁模型、优先级顺序和失败回退有什么不同。
- 阶段 11 实践:授权矩阵与注入演练
- 阶段 5 讲义:工具契约
- 阶段 12 讲义:产品设计
- 学习路线
 苏公网安备32011402012723号