agent 的一切都始于模型调用,但模型调用本身是个大泥潭:每家 provider 的请求格式、流式协议、错误分类都不一样。这一章看 dsh 怎么把这个泥潭变成一个干净的 seam(接缝):ctx.llm 的词汇设计、两个适配器的分工、以及本机实测的三个自定义 provider 是怎么接进来的。
每篇 dsh 文档末尾都有一个固定小节叫「模型体验」,回答三个问题:模型看到什么、token 影响、KV Cache 影响。这个"三段式"视角本身就是 dsh 的设计特色 —— 本章末尾会解释它为什么重要。
假设你要让 agent 支持三个模型:Claude(Anthropic Messages API)、GPT(OpenAI Responses API)、DeepSeek(OpenAI 兼容)。
最朴素的做法是写三个分支:
async function callModel(provider, messages) {
  if (provider === 'anthropic') return callAnthropic(messages);
  if (provider === 'openai') return callOpenAI(messages);
  if (provider === 'deepseek') return callOpenAICompat(messages);
}
马上遇到的问题:
dsh 的答案是 dsh-llm 这个 Service Definition 包:定义一套 provider 中立的词汇,让 agent loop、会话日志、所有插件都只面对这一套词汇。
dsh-llm 的定义 [官方文档]:
提供方无关的 LLM 词汇与抽象服务。本包定义 agent loop、会话日志和所有插件共同使用的规范词汇。 —— dsh-llm/README.zh.md
它包含几组概念:
所有模型的历史都统一成三种角色消息:
| 消息 | 用途 |
|---|---|
| UserMessage | 用户输入(含 agent 合成的上下文注入) |
| AssistantMessage | 模型输出(含 tool call) |
| ToolResultMessage | 工具执行结果 |
内容块(content block)类型:text / image / tool-call / tool-result / reasoning 等。流式输出按 assistant/chunk 事件逐块记录。
一次模型调用的参数打包成 LlmCallConfig:provider、model、reasoningEffort、maxTokens 等。它出现在第 8 章会讲的 request/header 事件里 [实测]:
每次调用可以带 purpose 归因 —— 比如 compaction(压缩摘要调用)、title(会话标题生成)。第 9 章会看到,DeepSeek 适配器据此前缀特殊的请求头(x-deepseek-harness-compact: 1),但不触碰模型可见的请求体。
dsh-llm 还负责密钥相关的校验逻辑 —— 毕竟 provider 中立意味着密钥管理也要中立。
dsh-llm 是抽象,dsh-llm-deepseek 和 dsh-llm-pi-ai 是两个真实适配器:
| 适配器 | 后端 | 本机是否启用 |
|---|---|---|
| dsh-llm-deepseek | DeepSeek chat-completions | 否 |
| dsh-llm-pi-ai | pi-ai(@earendil-works/pi-ai) | 是 |
有意思的是,dsh 的官方 DeepSeek 适配器是 dsh-llm-deepseek,但本机实际用的是 dsh-llm-pi-ai —— 它的 README 自称是"dsh-llm-deepseek 的设计验证孪生"(design-verification twin)。
dsh-llm-pi-ai 的 README 是全部包文档里最大的(32 KB),因为它要描述如何把 pi-ai(一个完整的第三方多 provider SDK)接进 dsh 的词汇。
理解:pi-ai 本身就是个多 provider 抽象层(第 1 章提到的 Pi 生态底层)。dsh 在它上面再包一层自己的词汇 —— 两层抽象。这是 seam 架构的典型形态:每一层只解决一个问题。
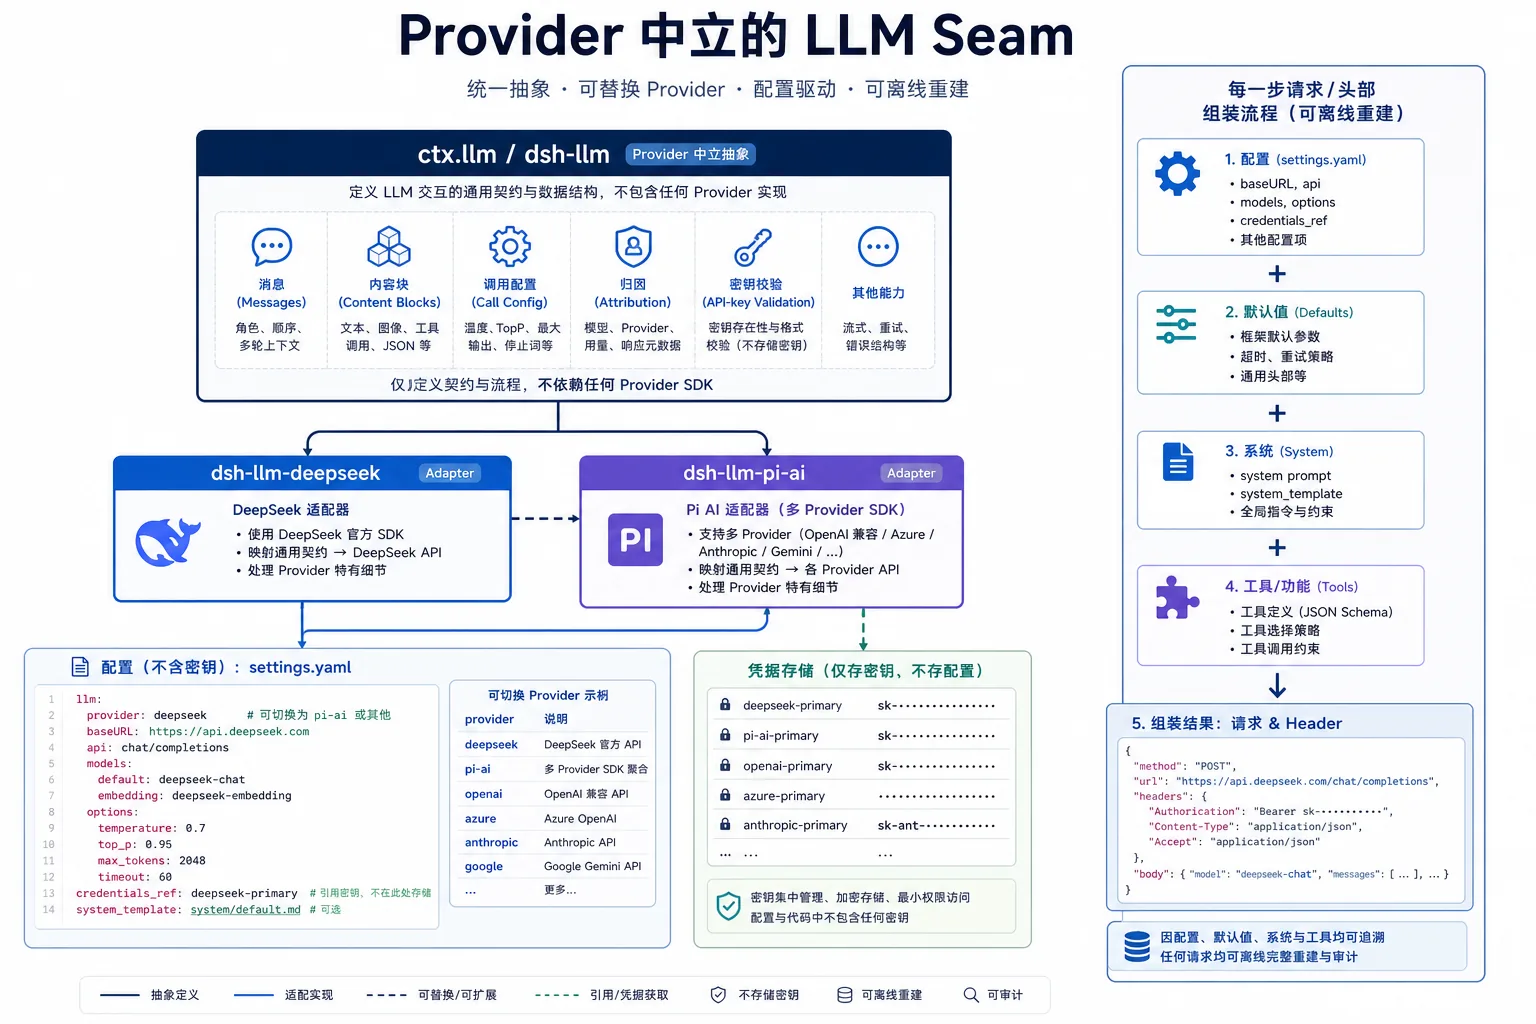
配图说明:ctx.llm 是 provider 中立的抽象词汇层;左侧是两个可换适配器(dsh-llm-deepseek 官方版与 dsh-llm-pi-ai 本机实际用的 pi-ai 封装);右侧是配置即 provider(settings.yaml:baseURL + api + models + apiKeyEnv)与每 step 落账的 request/header 事件(config + adapterDefaults + system + tools,可离线重建)。
dsh 的模型配置不在代码里,在 settings.yaml。本机实测的配置 [实测]:
三个值得注意的点:
agent-default-model 决定新会话的默认模型,但会话中可以随时 /model 切换(第 12 章会讲)。切换的底层机制是第 8 章的 request/context 事件 —— 它记录 provider/model 路由,仅在路由或容量变化时写入。
每个 step 开始前,dsh 会把"这次请求的完整 header"记录进会话日志。本机实测的 request/header 事件 [实测]:
这就是"可观测性"的落点:你可以在会话日志里看到模型当时收到的完整系统提示词和全部工具 schema。第 9 章会逐段拆解 system 字段里的 9927 字符。
request/header 有配套的重建工具(dsh-session/lib/types/request-header.d.ts):
任何持有会话日志的人,通过取最新规范快照即可重建任何请求的 EpochHeader;循环用同一个相等性工具避免记录未变化的 header。 【来源:dsh-session/lib/types/request-header.d.ts】
三个导出:canonicalHeader()(空 system 和空工具列表变成缺席字段)、headerEquals()(工具 schema 按顺序比较)、foldRequestHeader()(纯离线重建路径)。
adapterDefaults 是一个精巧的机制。它标记哪些字段是精确模型解析填入的默认值,使下一次请求能够把它们与用户显式设置区分开:
【来源:dsh-agent-loop/lib/index.js:330】
以及重建会话时:
【来源:dsh-agent-loop/lib/index.js:678】
理解:如果某字段是适配器填的默认值,换模型后它应该被重新解析(因为新模型可能有不同默认);如果是用户显式设置的,就要跨模型保留。adapterDefaults 就是这个区分标记。
模型调用会失败:限流、超时、5xx。dsh-llm-retry 提供 provider 路由的重试策略:
提供方路由的 LLM 请求重试策略。 —— dsh-llm-retry/README.zh.md
会话日志里也有对应的事件类型:llm/retry、llm/retry-started(第 8 章的 43 种事件类型之一)。
理解:重试策略按 provider 路由,是因为不同 provider 的限流语义不同(有的返回 429 带 Retry-After,有的直接 5xx)。统一重试会撞错 provider 的脾气。
dsh 的每个包 README 末尾几乎都有这个固定结构:
| 小节 | 回答的问题 |
|---|---|
| 模型看到的内容 | 这个插件会不会往模型上下文里塞东西?塞什么? |
| Token 影响 | 塞的东西花多少 token?被阻止的会不会白花? |
| KV Cache 影响 | 这个插件会不会让提供方的 KV Cache 失效? |
这个结构本身就是一个设计声明:dsh 把"对模型的可见性、token 消耗、缓存失效"当作每个插件的公共责任。任何一个插件加入上下文,都要交代这三件事。
dsh-agent-loop 的模型体验章节里有一个具体的例子:
已接受内容成为保留历史,或成为每次请求都会重复的会话前缀;被阻止内容不贡献请求 token。大小取决于调用方与插件。 KV Cache 影响:已接受历史与 steering 只追加;会话前缀在循环实例内保持稳定,而新建或恢复的实例可能建立不同前缀。 —— dsh-agent-loop/README.zh.md
KV Cache 视角为什么重要? 因为对于大上下文模型,缓存失效的代价远超 token 本身 —— 一次失效意味着整个前缀要重新计算。第 9 章的压缩设计(回放前缀复用缓存)就是围绕这个视角展开的。
模型调用在 dsh 里是一个干净的 seam:
下一章是模型能做什么的关键:工具系统 —— 五段流水线与两种呈现。
 苏公网安备32011402012723号