核心观点 roadmap 的第一轮不是功能,是全项目最大的技术假设。用一个 spike 把它验证到「可承诺」:门禁写成可证伪、数字必须真实、止损预案先写、不过就停。spike 允许粗糙的是产品完成度,不是安全底线;spike 的产物是实测数据,代码在正式实现后移除。
Agent X-Ray 的架构有一个核心决定:agent 内核 SDK 以 in-process 的方式嵌入后端进程,不起独立的 sidecar。这个决定影响一切——内存模型、事件订阅方式、SSE 的实现、部署规格。
在 R1 之前,这个决定只做过三层冒烟:SDK 能 import、能建会话、能在框架的请求处理器里执行。三层冒烟证明「能跑」,不证明「能承诺」。真正的问题是:一个真实的 LLM 对话能不能在请求内完整走完?34 种内核事件能不能全部订阅到?两条 SSE 流经反代和直连会不会被缓冲?内存代价是多少?
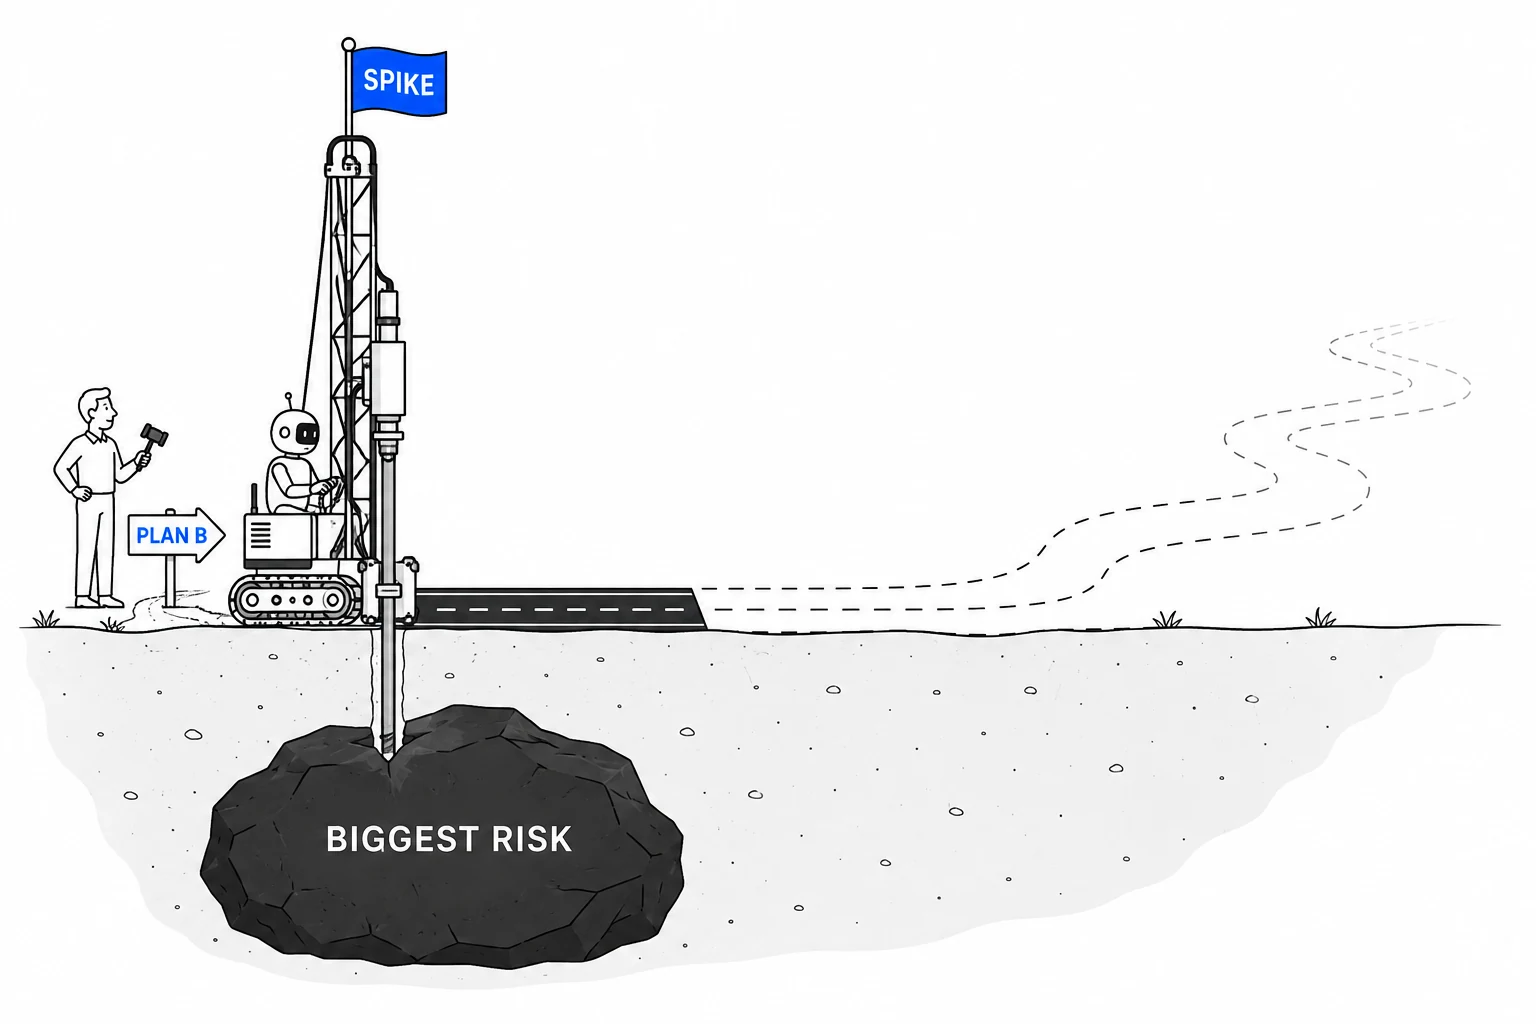
路还没铺,先在起点钻一口探井,看看地底下那块石头有多大。旁边立着 PLAN B 的路牌。
ROUNDS.md 把 R1 标成「全项目最大风险,先做」,里程碑表里 M0 的止损写着:「R1 任一门禁不过 → 停,重新评估 sidecar 形态并改写本表。」
这就是风险前置:第一轮做的不是最容易演示的功能,而是最可能推翻架构的假设。假设推翻了,损失是一轮;假设在第八轮才被推翻,损失是八轮。
R1 的任务卡有九项验收,每项都是可证伪的:
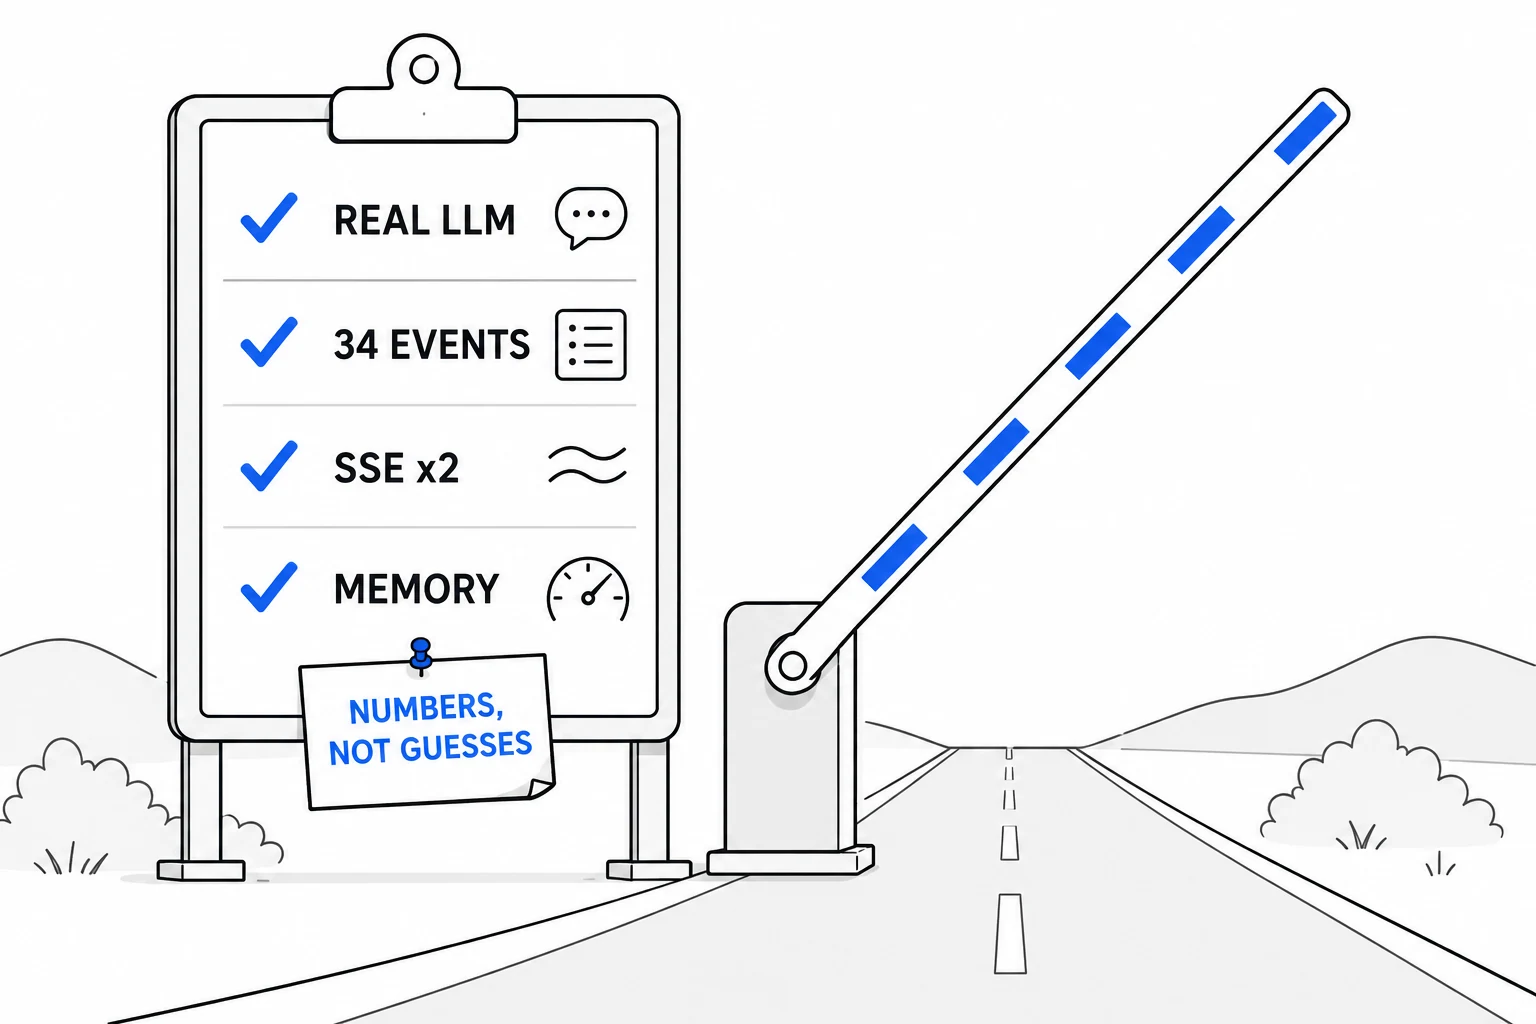
四类门禁:真实对话、全部事件、两条流、内存数字。栏杆抬起的条件是全部通过,而且数字是量出来的。
| 门禁 | 判据 | 结果 |
|---|---|---|
| 钉版本 | 精确版本入 lockfile,写进 CLAUDE.md | 通过 |
| 真实 LLM 对话 | 请求处理器内建会话、发提示、流式返回真实模型回复,不是 mock | 通过,中英文各一轮加同会话续问 |
| 34 事件订阅 | 全部订阅成功,四种模式计数与实测一致 | 通过,纯对话场景实际触发 16 种,其余需对应场景 |
| 模式计数核对 | 实测对文档 | 文档记的合计 33 是笔误,实测 34,回改 |
| SSE 直连不缓冲 | 逐事件到达,非整体一次性 | 通过,带毫秒时间戳采样 |
| SSE 经开发反代 | 同上,长连接不断流 | 通过,心跳 15 秒 |
| 内存基线 | import 增量、单会话增量、10 轮创建销毁后回落 | import +96.3 MB;单会话约 0.4 MB;10 轮残留 0.6–0.9 MB,无单调增长 |
| 凭据不泄漏 | 抽查 SSE 原始输出无凭据字段;仓库 diff 无 key 片段 | 6 份采样零命中 |
内存基线那一行值得看。数字回填任务卡之后,直接成了部署规格的依据:「in-process 固定成本约 100 MB,会话边际成本极小;容器内存上限 512 MB 起步即可,重点盯长对话历史与事件缓冲。」没有这个数字,容器规格只能猜。
任务卡还记了测量的局限:进程无法强制 GC,数字是自然回收口径。局限也是证据的一部分。
spike 允许粗糙,但粗糙有边界。R1 任务卡的写法给出了几条纪律:
允许粗糙的是产品完成度,不是数字。 ROUNDS.md 的原话:「产出物是 spike 代码 + 实测数据,允许粗糙,但事件清单与内存数字必须真实。」
验收写成可证伪。 不是「验证 in-process 可行」,是「34 个事件名全部订阅成功」「10 轮创建销毁后 RSS 回落」。每条都能用一个命令或一次采样判定。
止损预案先写。 任务卡「失败处理」段:「重点预案:sidecar 形态重评估。」在开工前就知道失败了往哪走。
spike 代码有明确的退出时间。 任务卡「禁止」段写着:spike 端点是验证脚手架,不是产品功能,正式实现后移除。R3 和 R4 落地正式的对话流与轨迹流后,spike 服务被删除;镜像构建的服务白名单把它排除在外。
已知的范围外事项在任务卡里声明。 spike 端点没有认证、没有限额、有会话上限竞态——这些审查者可能报的问题,任务卡「禁止」段提前写明属于已知 spike 范围,限额是后面某轮的交付。审查报了,处置是「不整改,属已知范围」,有据可查。
spike 的第二个产出是纠正文档。R1 纠正了三处:
这些都是「设计时想的」与「实测是什么」的差距。spike 的价值之一就是把这些差距在第一轮找出来,而不是在第六轮的生产冒烟里。
R1 是 spike 轮,但它走了完整的审查循环,而且是项目里第一次用对抗式复审。
第一轮审查报了两条:SSE 事件脱敏应为白名单而非黑名单(P1),某个事件的处理器必须返回特定结构否则 SDK 会抛异常(P2)。两条都采纳。P1 那条改变了整个事件流的脱敏形态——安全文档是强约束,不因为「这是 spike」而推迟。
所有者问询后补做了对抗式复审,针对两条整改本身。复审又报了两条:白名单里的富字段仍在递归复制未知嵌套结构,凭据键黑名单漏了几种变体,字符串值里的凭据不检测(high);没有单事件总量上限,大对象能放大 SSE 与内存(medium)。两条都采纳,并按复审建议加了脱敏自测夹具(六组:凭据键变体、深层嵌套、字符串值凭据、请求头、未知字段、超大对象),整改后六组全过。
这一段确立了一条后来写进 CLAUDE.md 的规则:禁止以「spike 会被替换」为由跳过整改。spike 的代码会被替换,但 spike 里确立的脱敏形态会被正式实现继承——R1 的白名单就是后来「采集点即脱敏点」的起点。
投产之后还有一次 spike,形态更小。R-SKILLS-2 要让 agent 在独立容器里跑脚本,api 进程与执行容器之间的通道裁定为 unix socket——api 容器不挂 docker socket,造不出「每次一个容器」,所以是常驻容器加一条 socket。
但有一个没验证过的假设:在这个 JS 运行时里,fetch 能不能走 unix socket?两个无网络的容器经命名卷共享 socket 能不能通?
研究文档的裁定原文:「spike 不过 → 不进 2.0,回所有者重裁,不自行退到共网。」失败的出路不是「那就让容器进网络」——那会推翻「执行容器无网络」这条裁定——而是停下来。
spike 结果:通了。两个 network_mode: none 的容器经命名卷里的 unix socket 通信,运行时的 fetch 带 unix 选项可用。留证在任务卡「本轮实测」。附带发现一条环境限制:这个运行时在 Windows 上不支持 unix socket,所以本机测试走 TCP,unix 路径只在 Linux 容器与生产验——这条进了项目记忆。
不是每个假设都值得一轮。第 07 章讲过风险验证的判据,spike 是它的实操形态:
spike 变成半成品功能。 舍不得删,越长越大,最后既不是验证也不是产品。R1 的退出时间从一开始就写在任务卡里。
数字是估的。 「内存应该不会太大」不是基线。基线是带测量方法与局限说明的数字。
没有止损预案。 门禁不过时现场商量,容易滑向「那就放宽一点」。
spike 不审查安全。 「反正会被替换」——但形态会被继承。
spike 之后不回改文档。 实测发现的差距留在任务卡里,架构文档还写着设计时的数字。R1 把三处都回改了。
列出自己项目的前三个技术假设——那些一旦不成立就要改架构的。为每个写一条可证伪门禁(一个命令、一个期望值)和一个止损预案(不过时往哪走)。然后问:第一轮做的是这三个里的哪一个?如果都不是,重排。
| 编译 | 框架检查通过 | 通过 |
 苏公网安备32011402012723号