第4章:消息系统与事件流 —— 内部表象与模型请求的分离
在简单或玩具级的 Agent 框架中,对话历史通常只是一个扁平的 Vec<ChatMessage> 数组,调用模型时直接将其序列化后通过 HTTP 发送。但在工业级桌面 IDE 中,这种简陋的设计会导致灾难性的后果。本章将深入剖析 Zed 的双层消息模型 —— 内部真实世界(Message)与大模型视野(LanguageModelRequestMessage)的解耦、13 种 ThreadEvent 构成的异步神经系统,以及上下文自动压缩引擎的设计。
一、开场:为什么内部记忆不能直接发给模型?
在深度拆解代码之前,必须先回答一个根本问题:为什么不能把编辑器里看到的对话历史原封不动发给 LLM?
在桌面 IDE 场景下,内部状态至少面临以下四大特殊挑战:
- UI 丰富性 vs 模型文本性:
用户在界面上看到的不仅是文本,还有可交互的 Diff 控件、折叠面板、终端 PTY 引用以及 @mention 选中的代码符号。这些复杂的本地实体无法直接以内存对象的形式发给 API,必须经过特定的序列化和裁剪;
- 上下文压缩与历史折叠(Compaction):
当长会话达到 128k 或 200k Token 上限时,旧的历史轮次必须被“折叠压缩”成一段高密度摘要发给模型。但在用户界面上,用户依然期望能向上滚动查看最初完整的代码和问答。如果内部状态与请求状态合一,折叠历史将直接导致用户端历史丢失;
- 撤销与编辑审阅(Accept / Reject):
用户可能会拒绝 Agent 的某一次代码修改。此时内部状态必须记录这次撤销行为以便提供 Undo 栈,但不能让被拒绝的代码继续污染模型的后续推理;
- 会话重放与恢复(Replay / Resume):
当用户从本地 SQLite 数据库中重新打开一个旧会话时,系统需要无歧义地还原断点状态,而不会向模型重复扣除 Token。
因此,Zed 在架构上实行了彻底的双层表象分离机制:
- 内部表象(Internal Presentation):以 Message 枚举为核心,作为本地状态持久化、UI 渲染与撤销审计的唯一真源;
- 网络请求表象(Request Presentation):通过 to_request() 编译管道,在每一次外层循环中动态投射为最适配当前模型的 LanguageModelRequestMessage。
二、内部表象:Message 枚举及其变体
在 crates/agent/src/thread.rs:203 中,内部消息被定义为一个多态枚举:
rust
// crates/agent/src/thread.rs:203-217
pub enum Message {
    User(UserMessage),
    Agent(AgentMessage),
    Resume,
    ContextCompaction(ContextCompaction),
}
【来源:crates/agent/src/thread.rs:203-217】
2.1 用户消息:UserMessage
rust
// crates/agent/src/thread.rs:283-295
pub struct UserMessage {
    pub id: ClientUserMessageId, // 客户端唯一标识,用于乐观更新对齐
    pub content: Arc<[UserMessageContent]>,
}

pub enum UserMessageContent {
    Text(String),
    Image(Arc<language_model::ImageContent>),
}
2.2 助手消息:AgentMessage
助手消息内部不仅包含普通的文本流,还包含了对思考过程(Reasoning / Thinking)和工具调用的细粒度追踪:
rust
// crates/agent/src/thread.rs:739-755
pub struct AgentMessage {
    pub id: Option<acp::MessageId>,
    pub content: Vec<AgentMessageContent>,
}

pub enum AgentMessageContent {
    Text(String),
    Thinking(String), // 深度思考链(如 Claude Thinking 或 DeepSeek R1)
    ToolUse(LanguageModelToolUse),
    ToolResult(LanguageModelToolResult),
}
【来源:crates/agent/src/thread.rs:739-755】
特别注意:Zed 将 ToolUse(模型发起的调用意图)和 ToolResult(执行后返回的数据)作为并列的内容块保存在同一个 AgentMessage 内部,而不是粗暴地拆分成两个完全独立的消息。这为后续向不同 Provider(如 OpenAI、Anthropic、Gemini)抹平工具调用格式提供了极大的灵活度。
2.3 恢复标记:Message::Resume
当会话从持久化数据库恢复,或者用户点击了“继续(Resume)”按钮时,系统会在消息序列中插入一个虚拟的 Message::Resume。
它在 UI 上表现为一个视觉分割标记,并在向模型组装请求时充当断点指示符,防止模型把恢复后的输入误认为是前一段命令的延续。
三、转换管线:从 Message 到 LanguageModelRequestMessage
那么,内部的 Message 数组是在哪里、以何种逻辑被编译成发往大模型的标准请求的?
核心转换引擎位于 Thread::build_completion_request(crates/agent/src/thread.rs:4038)和 Message::to_request(crates/agent/src/thread.rs:245)中。
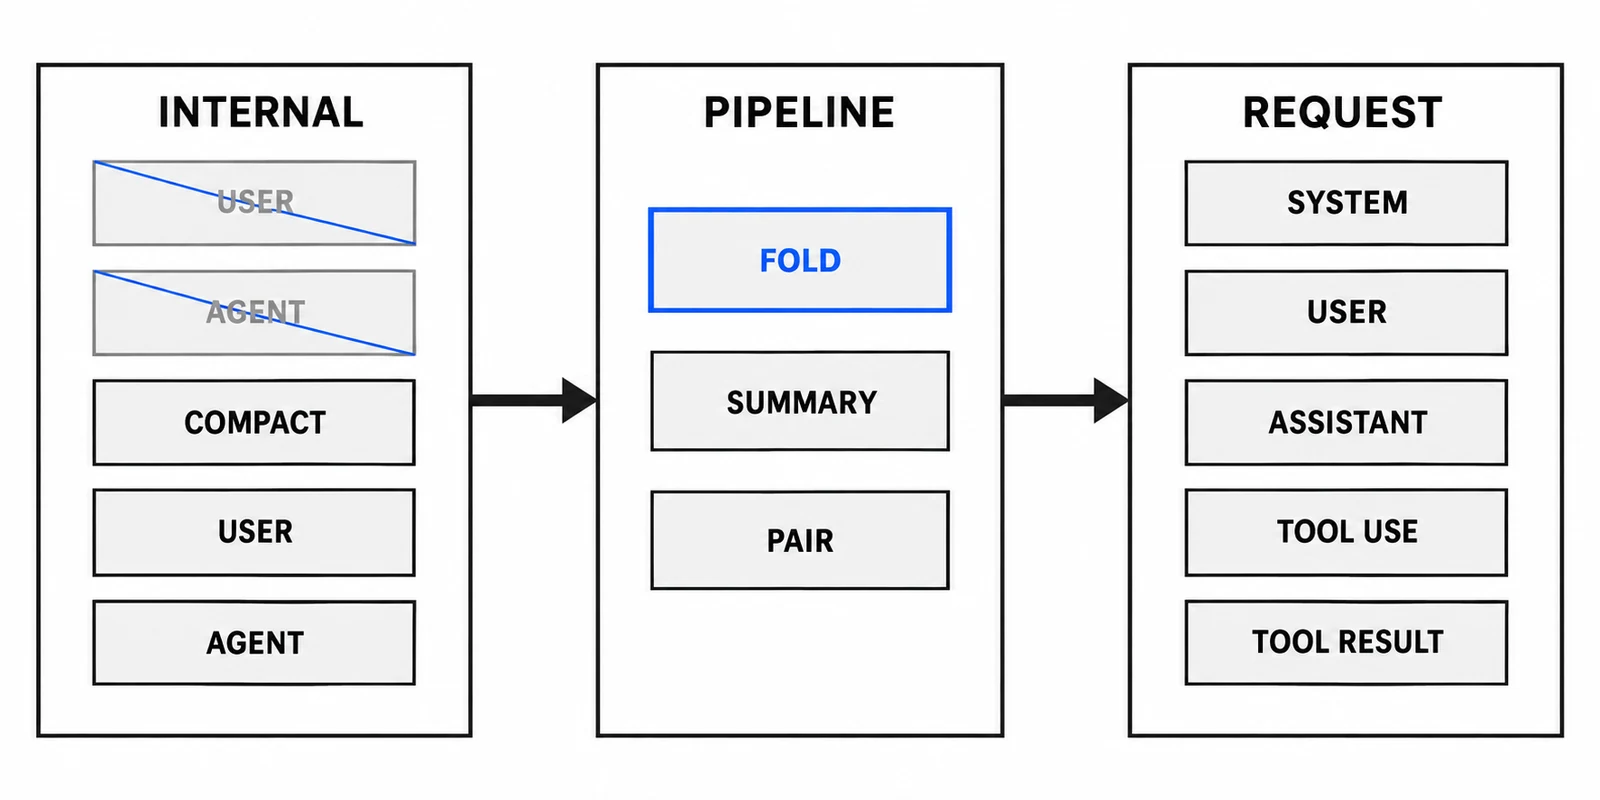
两层消息模型的解耦:左边是内部持久化的真实历史,ContextCompaction 是折叠点;编译管线跳过折叠点之前的旧消息、注入高密度摘要、再把 tool_use 与 tool_result 配对;右边才是真正发给大模型的请求序列。被划掉的两条不出现在网络请求里,但它们在本地一条都没少。
转换过程的关键原则:
- 压缩窗口裁剪:如果消息列表中存在 Message::ContextCompaction,转换管线会自动定位最后一次有效压缩边界,将该边界之前的所有历史消息直接裁撤,替换为该条目中保存的高密度文本摘要;
- 工具成对组装(Tool Pairing):某些 Provider(例如 OpenAI 系 API)对消息格式有着极端严苛的验证规则 —— 如果出现了一个包含 tool_calls 的 assistant 消息,紧接着的一条消息必须是角色为 tool 的结果消息,且 tool_call_id 必须严格一致。如果在流式接收过程中发生崩溃,导致 tool_use 孤立,转换管线会自动补全一个标记为 cancelled 的虚拟结果,防止整条 API 请求被上游抛出 400 错误直接打死;
- 图片多模态降级:如果当前选中的底层模型不支持图像输入(model.supports_images() == false),管线会自动过滤掉 UserMessageContent::Image,并替换为占位文本提示用户该模型无法查看视觉内容。
四、单调递增的全局标识:PromptId
在 crates/agent/src/thread.rs:155 中,存在一个看似简单却极度重要的类型:
rust
// crates/agent/src/thread.rs:155-163
#[derive(Debug, Clone, Copy, PartialEq, Eq, Hash)]
pub struct PromptId(Arc<str>);

impl PromptId {
    pub fn new() -> Self {
        Self(nanoid::nanoid!().into())
    }
}
每当用户输入新消息、点击重试(Retry)或发起压缩时,Thread 都会显式调用:
rust
self.advance_prompt_id();
为什么每个 Prompt 都必须拥有全局唯一且单调前进的 ID?
- 遥测关联性(Telemetry Correlation):
在复杂的异步环境中,一个用户的 Prompt 可能会触发 10 次模型往返和 15 次工具调用。通过在每一次请求中附带统一的 prompt_id,开发团队在日志系统中可以一眼看清整条交互链的所有成本与耗时;
- 过期任务熔断(Stale Response Defense):
假设由于网络慢,第 1 次调用的流式响应在 3 秒后才慢悠悠到达,而用户已经在第 2 秒点击了取消并重新发起了第 2 次询问。此时后台收到的第 1 次响应在对比本地当前的 this.prompt_id 时会发现已经不匹配,从而被立刻静默丢弃,绝对不会覆盖或污染用户的最新对话!
五、神经系统:13 种 ThreadEvent
Thread 状态机在内部工作时,并不直接操作 UI,而是通过一个异步无界通道向外界派发事件流。这些事件构成了原生 Agent 的完整神经反射弧:
rust
// crates/agent/src/thread.rs:890-906
pub enum ThreadEvent {
    UserMessage(UserMessage),
    AgentText(String),
    AgentThinking(String),
    ToolCall(acp::ToolCall),
    ToolCallUpdate(acp_thread::ToolCallUpdate),
    ToolCallAuthorization(ToolCallAuthorization),
    ToolCallAuthorizationResolved {
        tool_call_id: acp::ToolCallId,
        outcome: acp_thread::SelectedPermissionOutcome,
    },
    Elicitation(ElicitationRequest),
    SubagentSpawned(acp::SessionId),
    Retry(acp_thread::RetryStatus),
    ContextCompaction(acp_thread::ContextCompaction),
    ContextCompactionUpdate(acp_thread::ContextCompactionUpdate),
    Stop(acp::StopReason),
}
【来源:crates/agent/src/thread.rs:890-906】
13 种事件完整覆盖了智能体从思考、输出、申请授权、派生子代理到压缩与终止的所有状态变化:
| # | 事件名称 | 携带载荷与语义 | 触发时机 |
|---|
| 1 | UserMessage | UserMessage 实体 | 消息正式入库,通知上层确认 |
| 2 | AgentText | String 文本增量 | 模型流式吐出正文文本 |
| 3 | AgentThinking | String 思考增量 | 模型流式吐出推理思考链 |
| 4 | ToolCall | acp::ToolCall 完整结构 | 模型发起工具调用,注册新工具卡片 |
| 5 | ToolCallUpdate | 字段增量更新(如标题、输出) | 工具执行中流式更新状态与文本 |
| 6 | |
为什么用 mpsc::unbounded 而不是回调函数?
如果采用传统的 on_event(F: Fn(ThreadEvent)) 回调模式:
- 回调函数的执行线程与状态机绑定,一旦 UI 端在处理某个重绘时稍有阻塞,就会直接卡死状态机的主执行循环;
- 回调模式难以与 Tokio 异步生态中的 select!、stream.next() 无缝融合。
使用 mpsc::unbounded,状态机只管将事件放入队列,消费端可以在自己的节奏下批量拉取,彻底解除了生产者与消费者的执行期耦合。
六、上下文压缩引擎(Compaction Engine)
当开发者在一个项目中与 Agent 展开深度结对编程时,会话动辄持续数十轮,Token 消耗极易逼近上下文窗口极限。Zed 在 thread.rs:3134 中实现了一套极其精细的渐进式上下文自动压缩机制。
6.1 触发阈值计算公式
在 crates/agent/src/thread.rs 的单元测试中,明确揭示了压缩阈值的精确计算法则:
rust
// 逻辑等价算法:触发上下文压缩的条件
let max_tokens = model.max_token_count();
let max_output = model.max_output_tokens().unwrap_or(4096);
// 用户设置的触发比例(默认通常为窗口的 80%~85%)
let threshold_ratio = settings.compaction_threshold;

let trigger_tokens = ((max_tokens - max_output) as f64 * threshold_ratio) as u64;

if current_cumulative_tokens >= trigger_tokens {
    // 触发自动压缩 perform_compaction_if_needed
}
注意公式中的核心防御点:必须先减去 max_output_tokens!
如果一个模型的最大窗口是 128k,最大单次输出是 16k,如果不扣除 16k 就按 128k 去算阈值,那么在模型生成长代码的过程中,极大概率会直接中途撞碎在硬上限上,造成截断事故。
6.2 压缩模型的回退链(Fallback Chain)
在执行压缩时,系统不会死板地使用当前正在写代码的主模型:
- 优先使用专用压缩模型:开发者可以在配置中指定 compaction_model(例如用小巧便宜的 claude-3-5-haiku 或 gpt-4o-mini 专门负责总结历史);
- 优雅降级(Fallback):若配置的专用压缩模型未授权或不可用,自动回退到当前主线程模型,确保压缩流程绝不中断。
6.3 压缩摘要的无缝缝合
压缩成功后,旧的数万 Token 消息被折叠,生成的 Summary 被打包装入 Message::ContextCompaction 并写入历史。在随后的下一次模型请求中,模型看到的提示词变成了:
markdown
[System Prompt ...]
The previous conversation history has been compacted. Here is a summary of the work done so far:
<summary>
1. Examined src/main.rs and identified the memory leak in function parse_records.
2. Modified the buffer pool configuration in settings.json.
3. Ran cargo test; 14 passed, 1 failed (test_connection).
</summary>

[Current User Prompt ...]
Now fix the failing test_connection in tests/network.rs.
整个过程对用户完全透明,会话可以在一个极低的基础 Token 水平上持续无限轮次地运转下去。
七、动手复核
你可以在源码中执行以下命令,验证本章引用的核心数据和架构事实:
bash
# 1. 查看 Message 枚举的完整定义
sed -n '203,225p' crates/agent/src/thread.rs

# 2. 查看 13 种 ThreadEvent 枚举变体
sed -n '890,910p' crates/agent/src/thread.rs

# 3. 检查上下文压缩触发阈值测试用例
grep -n "async fn test_compaction_threshold" crates/agent/src/thread.rs -A 20

# 4. 查看 PromptId 的生成逻辑
sed -n '155,168p' crates/agent/src/thread.rs

# 5. 查看 AgentMessageContent 的 Thinking 变体
sed -n '745,755p' crates/agent/src/thread.rs
八、总结
双层表象的设计思想,是 Zed Agent 区别于开源社区大部分轻量级玩具的核心标志:
- 内部表象捍卫真实性与控制力:记录完整的 UI 状态、思考链、本地 Diff 与撤销快照;
- 网络表象追求适配性与经济性:在 to_request 管线中根据 Provider 特性即时编译,无缝融入上下文压缩摘要;
- 事件流驱动极致响应:13 种事件解耦前后台,让桌面体验始终如丝般顺滑。
在下一章中,我们将步入模型层,深度拆解 Zed 是如何用一套统一的抽象,驾驭多达 19 个主流 LLM Provider 的。
 苏公网安备32011402012723号