第7章:代码编辑内核 —— 流式模糊匹配与 EditSession
如果说终端操作赋予了智能体执行能力,那么对代码文件的高精度手术式编辑就是 Coding Agent 最具技术壁垒的看家本领。大模型输出的代码往往存在缩进微调、空白符差异或换行符不一致,精确匹配极易中断,全量覆写又消耗巨大且风险不可控。Zed 在底层构建了一套近 4000 行的流式编辑内核 —— 基于 Levenshtein 动态规划的行级模糊对齐、悬空反斜杠保护、自适应重缩进与字符级实时 Myers Diff。本章将彻底解开这套业界顶尖编辑内核的实现秘密。
一、开场:为什么“编辑代码”是 Coding Agent 的最高壁垒?
在设计一个代码编辑智能体时,业界通常有三种做法:
- 粗暴方案:全量重写(Full File Rewrite)
- 模型要修改一个 2000 行文件中的 3 行代码,必须把整个 2000 行文件原封不动从头到尾生成一遍。
- 代价:极其缓慢(数十秒),浪费海量输出 Token,且极易在中途发生截断,导致剩余文件内容彻底丢失。
- 简陋方案:精确字符串替换(Exact Substring Search & Replace)
- 要求模型提供 old_text 和 new_text,然后在目标文件中执行精确子串查找。
- 代价:极其脆弱。大模型在输出代码时,往往会因为格式化习惯将缩进从制表符(Tab)写成 4 个空格,或者少打一个尾部空行,或者换行符(CRLF vs LF)不匹配。在强行精确匹配下,工具会频繁抛出 Text not found 错误,迫使模型陷入无休止的重试循环。
- Zed 的终极方案:流式模糊行对齐与动态局部手术(Streaming Fuzzy Match Kernel)
- 允许模型只提供几行变更上下文;
- 在模型还在以 token 为单位流式吐出 JSON 的过程中,后台已经开始在真实的编辑器内存 Buffer 上计算行级模糊动态规划匹配;
- 自动容忍微小的缩进与排版偏差,自动计算缩进增量并对齐上下文,同时用 Myers 算法在用户屏幕上毫秒级绘制无闪烁的红绿色实时 Diff!
这套架构将代码编辑的成功率和响应速度推向了工业极限。
二、统一管线:EditSession 的设计
在 crates/agent/src/tools/edit_session.rs 中,EditSession 是 edit_file(局部修改)与 write_file(新建或覆写)两个工具背后的共享控制核心:
rust
// crates/agent/src/tools/edit_session.rs:32-58
#[derive(Clone, Copy, Debug, PartialEq, Eq)]
pub(crate) enum EditSessionMode {
    Write, // 整文件创建或覆写模式
    Edit,  // 局部手术式补丁模式
}

#[derive(Clone, Debug, Serialize, Deserialize, JsonSchema)]
pub struct Edit {
    /// 目标文件中待匹配查找的代码片段(允许微小的排版与空白偏差)
    pub old_text: String,
    /// 准备替换上去的新代码片段
    pub new_text: String,
}
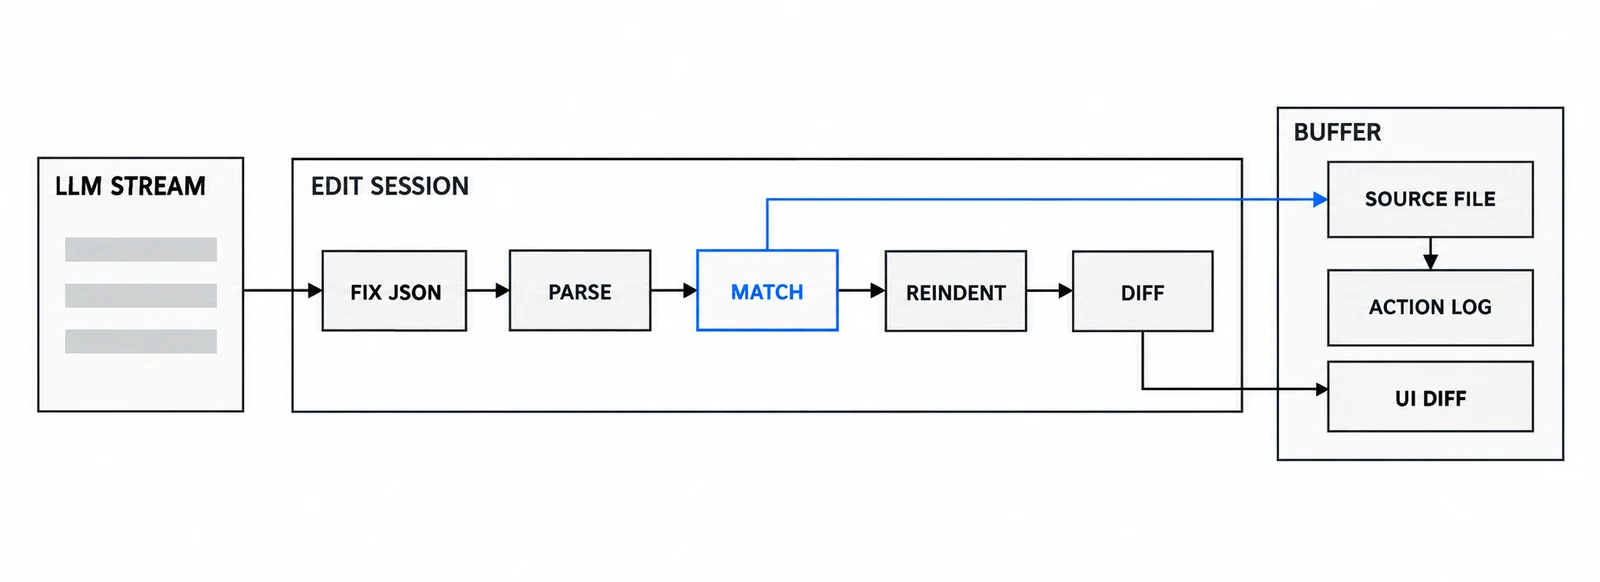
流式编辑的五段管线:修复不完整 JSON → 增量提取 Delta(含悬空反斜杠拦截)→ Levenshtein 行级模糊对齐 → 重算缩进 → 字符级 Myers Diff。命中的范围直接写进编辑器已打开的 language::Buffer,所以 Tree-Sitter 与 LSP 立刻响应,变更也自动进撤销栈。
EditSession 最本质的特征在于:它直接操作 Zed 编辑器底层的 language::Buffer 实体,而不是在磁盘上读写临时文件。
这意味着在编辑发生的一瞬间,Tree-Sitter 语法高亮树、LSP 诊断分析器立刻全部响应,且所有变更自动纳入编辑器的撤销重做(Undo/Redo)历史。
三、边推边解:StreamingParser 与悬空反斜杠防御
在流式工具调用中,模型是逐字发送 JSON 字符串的。为了让下层的模糊匹配算法尽早启动,系统必须能解析出“半成品的 JSON”。
Zed 引入了 partial-json-fixer 来补全未闭合的括号和引号。但在这一环节,团队遭遇了一个隐蔽而致命的 Bug:转义截断事故。
在 crates/agent/src/tools/edit_session/streaming_parser.rs:38 中,有一段极其硬核的架构注记:
rust
// crates/agent/src/tools/edit_session/streaming_parser.rs:38-55
/// Converts incrementally-growing tool call JSON into a stream of chunk events.
///
/// Because partial JSON comes through a fixer (`partial-json-fixer`) that
/// closes incomplete escape sequences, a string can temporarily contain wrong
/// trailing characters (e.g. a literal `\` instead of `\n`). We handle this
/// by holding back trailing backslash characters in non-finalized chunks: if
/// a partial string ends with `\` (0x5C), that byte is not emitted until the
/// next partial confirms or corrects it. This avoids feeding corrupted bytes
/// to downstream consumers.
#[derive(Default, Debug)]
pub struct StreamingParser {
    edit_states: Vec<EditStreamState>,
    content_emitted_len: usize,
}
【来源:crates/agent/src/tools/edit_session/streaming_parser.rs:38-55】
致命的 \ 截断场景还原:
- 模型原本要输出一个换行符 \n;
- 在流式切片中,第 1 个 chunk 恰好只送达了前面的反斜杠 \;
- partial-json-fixer 为了让 JSON 保持合法,会自动将尾部的单个 \ 视作一个字面量字符补全闭合;
- 如果 StreamingParser 此时直接将这个字符送入下层的模糊匹配器,匹配器就会在代码里寻找一个真正的反斜杠字符,导致匹配瞬间破裂!
- 紧接着第 2 个 chunk 送达了 n,修复器这才发现原来是 \n(换行),但下层已经被污染了。
Zed 的优雅解法:
StreamingParser 在发出事件前做了一层拦截:如果发现当前 chunk 的末尾字节是 0x5C(\),故意将这个字节暂扣在缓冲区内(Hold Back)。直到下一个 chunk 送达、确认了这个反斜杠到底是一个普通字符还是转义序列的一部分之后,才正式向下发射!
四、核心算法:StreamingFuzzyMatcher(流式增量模糊行匹配)
在 crates/agent/src/tools/edit_session/streaming_fuzzy_matcher.rs 中,驻扎着整个编辑内核最核心的算法。
4.1 惩罚矩阵的权重哲学
当文本出现偏差时,算法如何度量两段代码的相似度?Zed 设定了经过大量工业调优的三大成本常量:
rust
// crates/agent/src/tools/edit_session/streaming_fuzzy_matcher.rs:4-10
const REPLACEMENT_COST: u32 = 1; // 替换代价:极低(容忍缩进或标点微调)
const INSERTION_COST: u32   = 3; // 插入代价:中等
const DELETION_COST: u32    = 10; // 删除代价:极高(严惩遗漏代码行!)

// 只要发现 2 处完全匹配,立刻判定为歧义并中止扫描
const MAX_EXACT_MATCHES: usize = 2;
【来源:crates/agent/src/tools/edit_session/streaming_fuzzy_matcher.rs:4-10】
为什么删除代价(10)远高于替换代价(1)?
因为大模型最容易犯的错误是把几个空格写成 Tab(属于微小替换),或者在某行中间加了一个空格。
但如果模型提供的上下文里凭空少了一整行核心逻辑代码,这意味着模型记错了上下文结构!如果此时系统还宽松地把这行代码“当成被删除”而强行匹配上去,就会造成严重的代码覆写事故。因此,删除成本被重重惩罚,防止算法把不完整的片段胡乱匹配到用户的函数上。
4.2 歧义熔断(Ambiguity Abort):MAX_EXACT_MATCHES = 2
在代码文件中,很多行长得一模一样,例如:
- }
- return Ok(());
- let _ = cx.notify();
如果模型只提供了这样一条过于简短的 old_text,系统应该怎么做?
很多简陋的 Agent 会直接替换它匹配到的“第一个”出现处 —— 这往往把文件顶部的括号改掉了,破坏了整个语法结构。
Zed 的规则坚如磐石:
rust
// crates/agent/src/tools/edit_session/streaming_fuzzy_matcher.rs:8-10
// Two matches are enough to prove ambiguity, so stop scanning early; exact
// matches are byte-identical and can't be ranked.
const MAX_EXACT_MATCHES: usize = 2;
只要模糊匹配器在全文中扫出了第 2 处一模一样的候选区间,算法立即短路退出,并向上抛出明确的错误:
“Found multiple exact matches for replacement. Please provide more surrounding lines in old_text to uniquely identify the location.”
这倒逼大模型在下一次推理中带上被替换代码前后的 2~3 行独特上下文,以 100% 确定性的方式完成手术。
五、智能重缩进:Reindenter
模型编写替换代码时,常常习惯性地从第 0 列开始缩进,或者因为模型自身的格式化习惯,将一个原本应该缩进 12 个空格的深层代码块写成了 4 个空格。
如果直接替换进 Buffer,会导致目标文件的缩进结构彻底变形(尤其是在 Python、YAML 等对缩进敏感的语言中会直接破坏语法)。
crates/agent/src/tools/edit_session/reindent.rs 实现了自适应重缩进:
rust
// crates/agent/src/tools/edit_session/reindent.rs:18-40
pub fn compute_indent_delta(
    original_text: &str,
    replacement_first_line: &str,
) -> Option<IndentDelta> {
    let original_indent = extract_leading_indent(original_text);
    let replacement_indent = extract_leading_indent(replacement_first_line);

    // 计算原始上下文与模型输出之间的缩进差值量
    Some(IndentDelta {
        delta: (original_indent.len() as isize) - (replacement_indent.len() as isize),
        is_tabs: original_indent.contains('\t'),
    })
}
在执行真正的文本修改前,Reindenter 会分析原文件中被替换区域的首行缩进,动态平移 new_text 中的每一行,确保插入的代码天衣无缝地融入宿主文件的排版规范中。
六、视觉实时渲染:StreamingDiff
在传统编辑器中,当 Agent 执行完编辑后,界面通常会突兀地刷新一次。
而在 Zed 中,当你看着 Agent 工作时,编辑器的文件会行内实时、一个字符一个字符地展开红绿色 Diff 对比。
这个震撼体验的核心驱动是 crates/streaming_diff/src/streaming_diff.rs(1,446 行)。
它实现了一个增量式的、可复用动态规划矩阵的 Myers Diff 算法:
rust
// crates/streaming_diff/src/streaming_diff.rs 核心矩阵管理
pub struct StreamingDiff {
    old_rope: Rope,
    new_rope: Rope,
    matrix: Matrix,
}

impl StreamingDiff {
    /// 随着 new_text chunk 逐步到达,动态向后追加并局部重算最小编辑距离
    pub fn push_new_text(&mut self, chunk: &str) -> Vec<CharOperation> {
        // 返回新增的 Insert / Delete / Keep 操作序列,驱动 UI 实时渲染
    }
}
由于采用了 Rope 数据结构与高效的稀疏矩阵列置换(swap_columns),字符级 Diff 的计算耗时被严格压制在微秒级别,即使文件长达数万行,也能实现 60 FPS 的黄绿红差异条实时推演。
七、安全审计与撤销栈:ActionLog
在 crates/action_log/src/action_log.rs(3,552 行)中,Zed 实现了智能体操作的最终兜底防线。
每一个被 Agent 触碰过的 Buffer,都会在 ActionLog 中登记:
rust
// crates/action_log/src/action_log.rs:27-50
pub struct PerBufferUndo {
    pub buffer: WeakEntity<Buffer>,
    pub edits_to_restore: Vec<(Range<Anchor>, String)>,
    pub status: UndoBufferStatus,
}

pub enum UndoBufferStatus {
    Modified,
    Created { had_existing_content: bool },
}

pub struct LastRejectUndo {
    pub buffers: Vec<PerBufferUndo>,
}
审阅与撤销的工业级考量:
- 一键审阅全部变更(Accept All / Reject All):
用户在对话流底部拥有绝对主权。如果 Agent 连续修改了 7 个文件,用户点击“Reject”,ActionLog 自动按逆序激活每一个 Buffer 的 edits_to_restore,一瞬间将全部 7 个文件完整还原回改动前的状态;
- 多 Agent 审计流汇聚(linked_action_log):
如果主 Agent 通过 spawn_agent 委派了两个子 Agent 并发去修改不同模块的代码,子 Agent 会持有母体的 linked_action_log。子 Agent 实施的所有修改,会自动向主线程的审阅面板冒泡,用户无需在多个子窗口间疲于奔命,在主界面即可集中审阅整批修改。
八、动手复核
你可以在本地源码检出中执行以下命令,验证本章提到的算法常量与关键实现:
bash
# 1. 验证 Levenshtein 模糊匹配算法中的惩罚常量定义
sed -n '4,15p' crates/agent/src/tools/edit_session/streaming_fuzzy_matcher.rs

# 2. 查看 StreamingParser 中暂扣反斜杠的注释与逻辑
grep -n -C 5 "holding back trailing backslash" crates/agent/src/tools/edit_session/streaming_parser.rs

# 3. 检查歧义检测与多重匹配提前退出的逻辑
grep -n -C 5 "MAX_EXACT_MATCHES" crates/agent/src/tools/edit_session/streaming_fuzzy_matcher.rs

# 4. 查看 Reindenter 缩进增量计算代码
sed -n '15,35p' crates/agent/src/tools/edit_session/reindent.rs

# 5. 查看 ActionLog 中撤销状态机的定义
sed -n '25,45p' crates/action_log/src/action_log.rs
九、总结
代码编辑内核是 Zed Agent 架构中最耀眼的工程明珠:
- 算法有温度,更有底线:以 1:3:10 的非对称惩罚拥抱模型的合理微差,以 MAX_EXACT_MATCHES = 2 坚决熔断不确定修改;
- 微观细节见真章:StreamingParser 连半个转义反斜杠的风险都不放过;
- 全栈性能协同:从内存 Buffer 到 StreamingDiff 再到 ActionLog,构成了桌面级 IDE 独步天下的丝滑编辑体验。
在下一章中,我们将离开编辑核心,转向另一个高频且极度危险的领域 —— 终端工具与文件系统检索工程。
 苏公网安备32011402012723号