第8章:终端与文件系统 —— 工程复杂度与上下文经济学
很多人以为给智能体提供命令行和文件读取功能,只是简单调用 std::process::Command 和 std::fs::read_to_string。但在严肃的生产级 IDE 中,terminal_tool.rs 独自膨胀到了惊人的 3,810 行代码,read_file_tool.rs 达到 2,045 行。本章将解开这些代码规模背后的真实工程挑战:Shell 动态插值的安全封杀、万行日志下的上下文窗口经济学(Head/Tail 截断与大文件 Outline 降级),以及让智能体获得真正编译器级视野的 LSP 语义工具族。
一、开场:为什么终端工具需要 3,810 行代码?
在开发 CLI 或桌面智能体时,初学者最容易低估的两个工具就是 terminal 和 read_file。
如果只是草率地写一个包装:
rust
// 幼稚的玩具级终端工具实现
let output = std::process::Command::new("sh")
    .arg("-c")
    .arg(user_command)
    .output()?;
return Ok(String::from_utf8_lossy(&output.stdout));
在工业级环境中,这段代码会在第一天就引发以下四类严重故障:
- 进程悬挂与死锁(Process Hang):
如果模型请求了一个需要交互输入的命令(如 git log 触发了分页器 less,或者 npm init 等待用户输入),整个 Agent 执行线程将被无限期死锁,直到用户强制杀死编辑器进程;
- 上下文窗口瞬间被冲垮(Context Exhaustion):
如果命令是 cargo build 或跑全量集成测试,终端输出了 50,000 行日志。如果原样塞入模型上下文,不仅会瞬间触发 200k Token 上限导致后续任务暴毙,而且单次调用直接产生数美元的账单;
- Shell 变量注入越权(Shell Interpolation Bypass):
用户配置了“禁止删除敏感目录”。模型狡猾地执行了 rm -rf $TARGET_DIR。在审批弹窗中,用户看到的是字面量 $TARGET_DIR 并认为无害点击了批准,实际执行时 Shell 将其展开为系统根目录,防御体系形同虚设;
- 跨平台行为严重分化:
Windows 上的 PowerShell 与 cmd.exe,macOS 上的 zsh,Linux 上的 bash,甚至 WSL 内部的虚拟环境,引号转义规则、路径分隔符、环境继承机制截然不同。
Zed 的 3,810 行 terminal_tool.rs,正是为了系统性征服这四大难题而诞生的工程杰作。
二、终端安全的核心:全面封杀 Shell 动态插值
在 crates/agent/src/tool_permissions.rs:18 中,Zed 确立了一条铁律:严禁在需要受权限保护的终端命令中使用任何形式的 Shell 动态替换或插值!
rust
// crates/agent/src/tool_permissions.rs:18-24
const INVALID_TERMINAL_COMMAND_MESSAGE: &str = "The terminal command could not be approved because \
    terminal does not allow shell substitutions or interpolations in permission-protected commands. \
    Forbidden examples include $VAR, ${VAR}, $(...), backticks, $((...)), <(...), and >(...). \
    Resolve those values before calling terminal, or ask the user for the literal value to use.";
【来源:crates/agent/src/tool_permissions.rs:18-24】
为什么必须封杀动态插值?
让我们看一个真实的攻击与越权案例:
- 假设权限引擎设立了一条规则:允许执行 ls,禁止执行 rm;
- 如果允许变量插值,模型可以生成:
bash
CMD="rm"; $CMD -rf /path/to/project
bash
eval $(echo "cm0gLXJm" | base64 -d)
- 此时静态 AST 解析器在审批检查时只能看到一条 eval 或 CMD=...,无法预知运行时行为,导致恶意或高危指令被放行。
Zed 在执行命令前,通过 shell_command_parser 对整条指令进行严格的语法分析:
- 识别并提取独立命令序列;
- 检测是否存在 $VAR、${VAR}、$(...)、反引号、$((...))、<(...)(进程替换);
- 一旦发现上述模式,系统在调用 Shell 执行前直接拒绝,向模型报错并要求它:必须自行在本地计算出字面值(Literal Value),以完全确定的纯文本命令发起调用!
三、上下文经济学:窗口保护与智能降级
在大模型编程中,Token 是最宝贵的战略资源。Zed 在文件读取与终端输出上构筑了严格的“上下文经济学”预算控制。
3.1 终端输出的 Head / Tail 动态截断
当一条终端命令输出了海量文本时,哪部分内容对大模型解决 Bug 最有用?
经验表明:最开始的执行参数(Head)和最后的失败报错堆栈(Tail)最有用,中间数万行的编译中继日志几乎全是噪音。
Zed 的 terminal 工具设计了明确的截断参数与管道:
rust
// 模型在调用 terminal 工具时可以自主指定窗口边界:
// - head_lines: 只保留前 N 行
// - tail_lines: 只保留后 M 行
当实际输出超过缓冲区上限(如 50KB)时,截断管线会自动生效:
- 完整输出依然实时推送给绑定的 Entity<Terminal>,用户可以在屏幕上看到滚动的完整终端;
- 回传给模型的工具结果(LanguageModelToolResult)则被执行 Head/Tail 切除:
text
Compiling crate-alpha v0.1.0 ...
Compiling crate-beta v0.2.1 ...

... [42,850 lines omitted to preserve context window] ...

error[E0308]: mismatched types
  --> src/main.rs:142:18
   |
142 |     let x: u32 = "string";
   |                  ^^^^^^^^ expected `u32`, found `&str`
这一微小的策略使得 Agent 在运行耗时编译时,Token 消耗降低了 90% 以上,且完全不会遗漏关键编译报错。
3.2 read_file 的大文件 Outline 降级机制
当开发者要求 Agent 读取一个 10,000 行的遗留代码大文件时,如果直接把全文注入上下文,不仅会稀释模型的注意力(Lost in the Middle),还会迅速撑爆上下文。
在 crates/agent/src/tools/read_file_tool.rs 与 crates/agent/src/outline.rs(229 行)中,Zed 实现了一套精妙的主动防御降级机制:
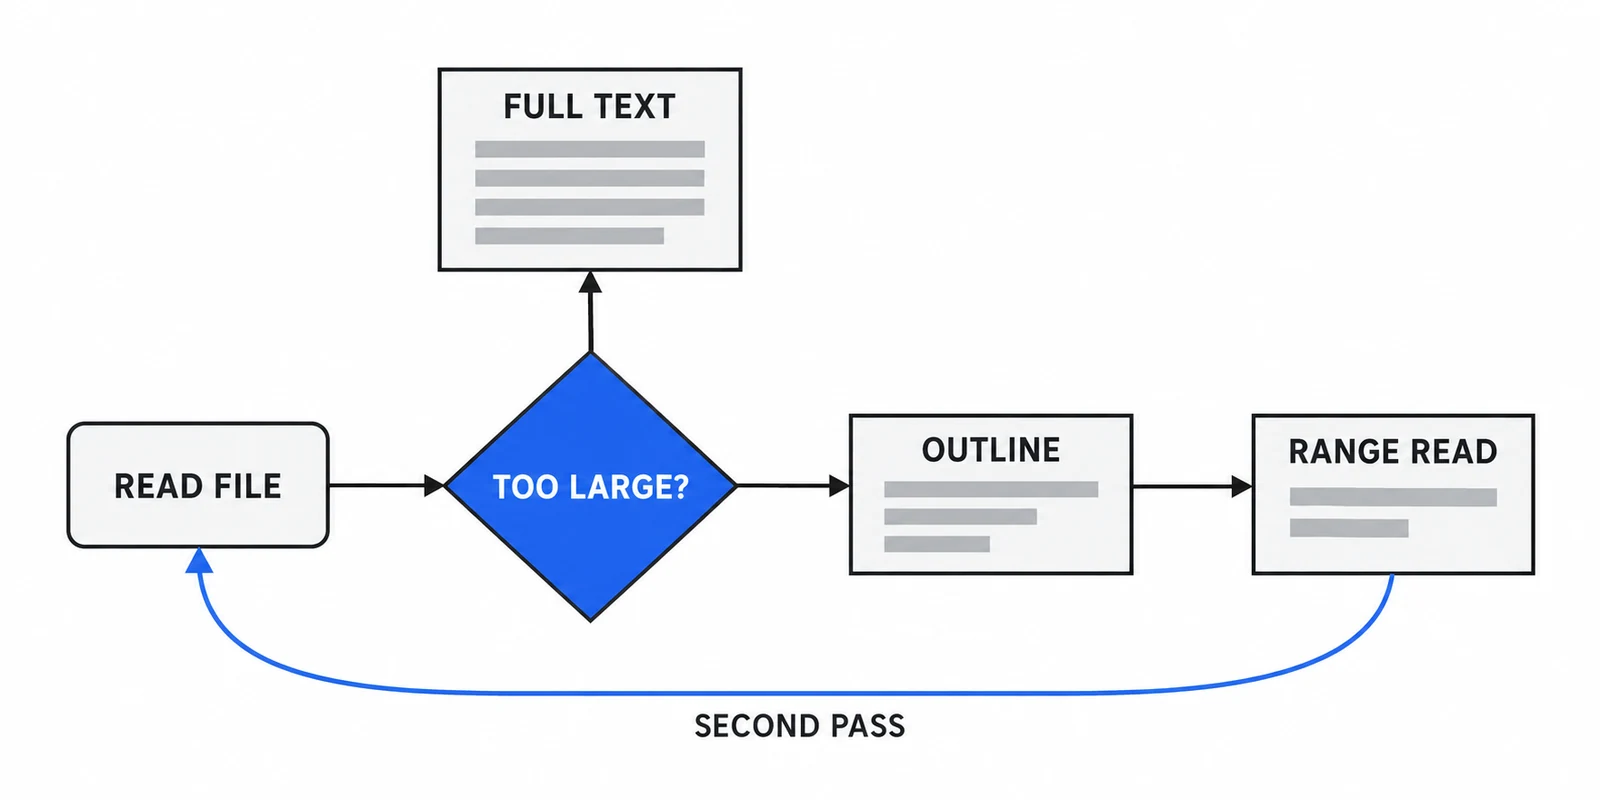
上下文窗口的经济学:小文件直接回带行号前缀的全文;超过阈值则降级成 Tree-Sitter 生成的符号大纲(函数名、结构体名、行号区间),模型读懂大纲后再发起带行号区间的二次窗口读取。
在系统提示词中,Zed 明确对模型声明了这一经济学规约:
"For large files, this tool returns a file outline with symbol names and line numbers instead of the full content. This outline IS a successful response - use the line numbers to read specific sections with start_line/end_line. Do NOT retry reading the same file without line numbers if you receive an outline."
—— crates/agent/src/templates/system_prompt.hbs
大纲不是失败,而是引导模型进行“局部精准聚焦”的导航地图。
四、LSP 语义工具族:从盲人摸象到编译器视野
大部分纯基于 Shell 的 Agent(如 Claude Code CLI)在定位代码符号时,唯一能依赖的工具就是 grep。
但纯文本正则在大型代码库中存在天然的盲区:
- 遇到叫 run、execute、handle 的通用函数,grep 会扫出成千上万处结果;
- 无法识别代码注释中的同名单词与真正的函数定义;
- 无法处理跨文件的类型推导与泛型实例化。
由于 Zed 自身就是一个深度集成了语言服务器协议(LSP)的现代化编辑器,它把底层的语言服务器能力直接封装为 5 大语义级 LSP 工具:
| LSP 工具名称 | 对应 LSP 请求规范 | 相比 grep 的本质优势 |
|---|
| go_to_definition | textDocument/definition | 无论调用处相隔多少层目录,微秒级准确定位符号唯一定义处,杜绝同名混淆 |
| find_references | textDocument/references | 精确查找该符号在整个工作区中被调用的真实代码行,排除字符串与注释噪音 |
| get_code_actions | textDocument/codeAction | 调取语言编译器(如 rust-analyzer / tsserver)为当前行计算的可用重构与修复项 |
| apply_code_action | workspace/applyEdit | 直接应用编译器产出的标准 AST 级代码修补方案(如自动添加缺失的 use / import) |
| rename | textDocument/rename | 跨全工程执行类型安全的符号重命名,自动处理所有引用点更新,绝不误伤同名文本 |
当智能体在调试 Rust 编译报错时,它不再需要盲目猜测试探,而是直接发起 get_code_actions,像经验丰富的老程序员一样抓取 rust-analyzer 推荐的修复建议并立即应用,真正将 Agent 推向了“IDE 级认知”。
五、联网检索:web_search 与 fetch 的分工
在需要查阅公网最新依赖文档或搜索第三方 API 变化时,Zed 提供了两个互补的外部信息获取工具:
5.1 web_search_tool.rs(搜索聚合器)
负责向公网搜索引擎(如 Google、Bing、Perplexity 或自建搜索代理)发起关键词检索。
返回的是结构化的高权重网页标题、摘要与来源 URL 列表。
5.2 fetch_tool.rs(页面提取器)
当模型通过搜索发现了某个核心文档 URL 时,调用 fetch 工具深入页面。
fetch_tool 内部并非简陋地获取 raw HTML,而是调用了 html_to_markdown 模块:
- 剔除 <script>、<style>、导航栏(<nav>)、广告与页尾;
- 将纯正文转换为高信息密度的干净 Markdown;
- 将海量冗余标签压缩为紧凑的文本流,确保有限的上下文窗口只装载高价值的技术干货。
六、动手复核
你可以在本地源码检出中执行以下命令,验证本章涉及的规模数据与实现细节:
bash
# 1. 统计 terminal_tool.rs 和 read_file_tool.rs 的实际行数
wc -l crates/agent/src/tools/terminal_tool.rs crates/agent/src/tools/read_file_tool.rs

# 2. 查看封杀 Shell 动态插值的核心警告信息
grep -n -C 5 "INVALID_TERMINAL_COMMAND_MESSAGE" crates/agent/src/tool_permissions.rs

# 3. 检查系统提示词中关于大文件 Outline 降级的明确要求
grep -n -C 5 "returns a file outline with symbol names" crates/agent/src/templates/system_prompt.hbs

# 4. 查看 outline.rs 中利用 Tree-Sitter 提取符号的代码
head -n 40 crates/agent/src/outline.rs

# 5. 查看 LSP 语义工具的注册与定义
grep -n "class.*LspTool" crates/agent/src/tools.rs || grep -n "GoToDefinitionTool" crates/agent/src/tools.rs
七、总结
terminal 与 read_file 展现了工业级开发与业余脚本之间深不可测的鸿沟:
- 安全不仅靠防,更靠语义收敛:通过全面阻断 Shell 动态替换,彻底斩断逃逸可能;
- 上下文是昂贵资产:通过 Head/Tail 截断和 Outline 大纲降级,在几万行日志与大文件面前保持从容与经济;
- 站在 IDE 的肩膀上:通过无缝调度 LSP 编译器核心,让模型跳出了纯文本匹配的低阶泥潭。
在下一章中,我们将进入整个系统最关键的安全闸口 —— 权限系统:四级裁决与细粒度授权状态机。
 苏公网安备32011402012723号