核心观点 「完成」的定义不是 agent 说完成,是有证据。任务卡的「本轮实测」段记实际数字、踩的坑、与计划的偏离;冒烟清单是活文档,每轮往上加;判据本身也会错,错了要改判据而不是改结论;本机验不了的写明交接给谁、何时验,「未验」也要写出来。
一个 agent 写完代码,说「已完成,测试通过」。这句话的证据是什么?
如果证据是它自己的记忆——「我刚才跑了测试」——那这句话不可验证。如果证据是一段实际的命令输出、一张截图、一个数字,那它可以被任何人核对。
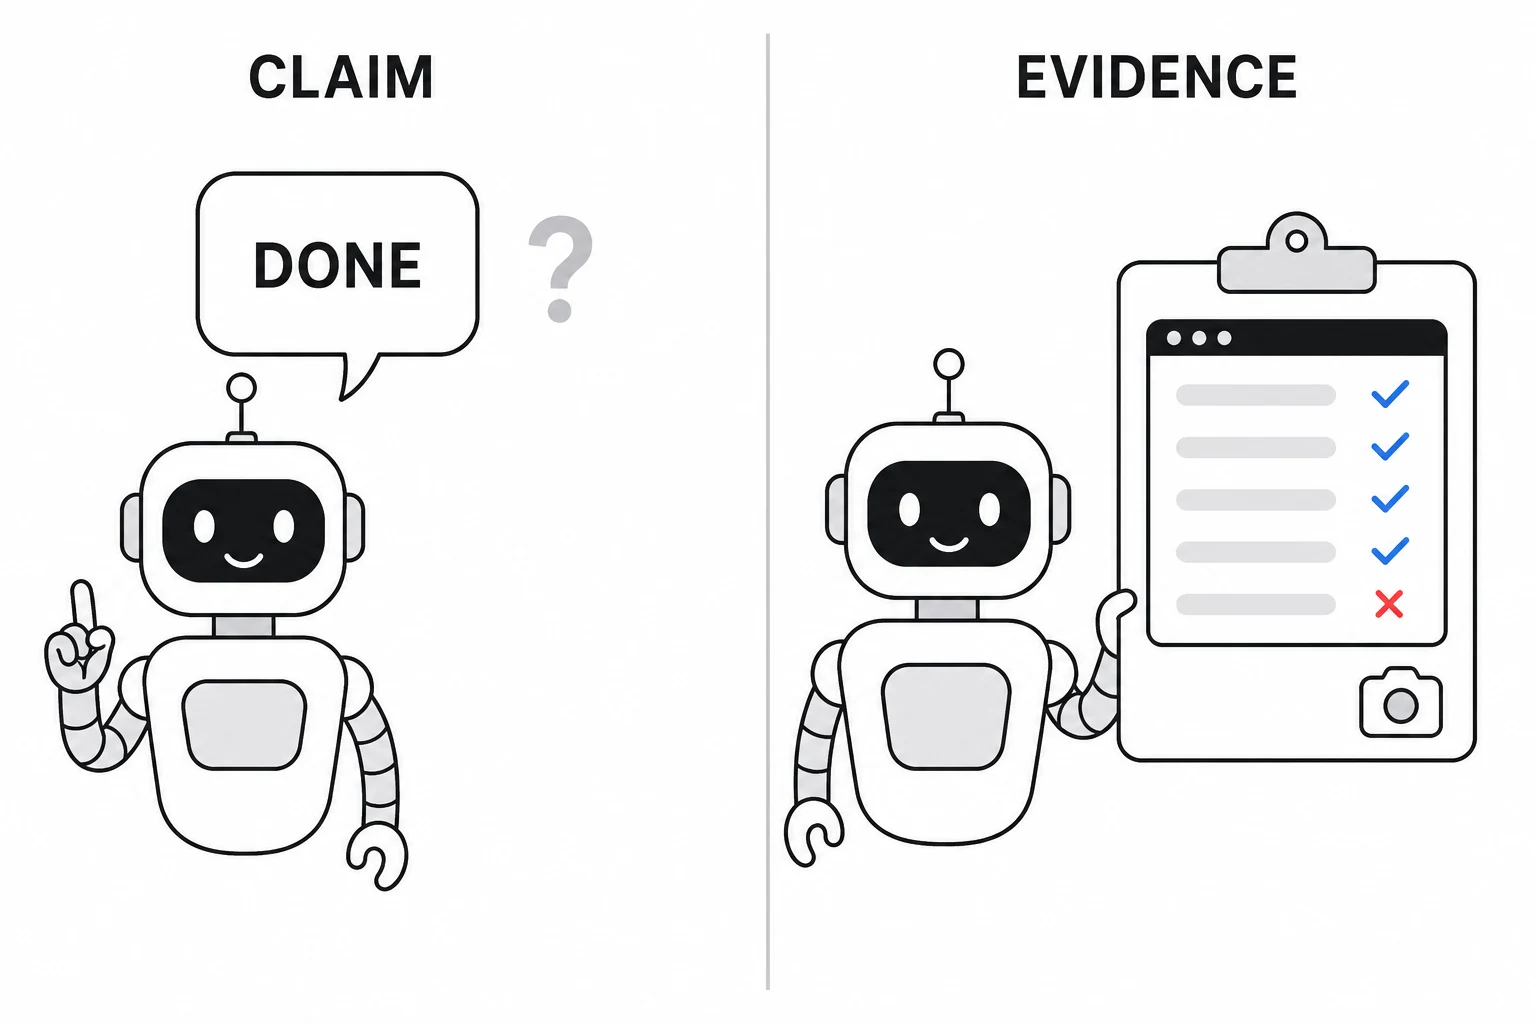
左边是一句「完成」;右边是命令、输出、通过与失败——失败的那一行也留着。
Agent X-Ray 的规矩写在第 10 章引用过的任务模板里:「汇报实际命令和结果,不以『理论上可运行』代替验证。」项目里的实践把它落成三样东西:任务卡的「本轮实测」段、部署文档的冒烟清单、发布记录的留证列。
每张任务卡最后一段叫「本轮实测」,模板注释写着:「完成后回填:实际数字、踩的坑、与设计 / 计划的偏离及原因。」
R1 的这一段是范例,结构是:
这一段的读者是三种人:审查者(核对验收有没有真做)、下一轮的实现者(知道哪些坑已经踩过)、所有者(判断这一轮能不能收口)。
「数字要真实」不只是不造假,还包括测量方法要经得起问。几个例子:
R-PERF 的标题锚点零漂移。 改动波及全站正文的渲染器,标题 id 一旦变了,文章里已有的锚点链接会集体失效——所以不能靠抽查。做法是从生产抓全量语料:13 个系列 225 篇章节,每篇同时抓改动前代码渲染出的 h2 id 序列(ground truth)和原始正文;外加 19 个 skill 的 56 个 markdown 文件,共 281 篇。用改动后的渲染器对同一批正文渲染,比对 id 序列。结果:225 篇失配零。另有 2 篇目录提取与渲染不一致,追下去发现是引用块里的标题这种既有问题,与本轮改动无关,记 BACKLOG。
R-PERF 的载荷瘦身。 详情页原来把整包 markdown 全部预渲染,改成只渲染当前文件。用同一套渲染器的静态输出体积做代理:两个最大的 skill 分别降 90.7% 与 89.4%。代价也量了:客户端要能渲染非首个文件,markdown 库进了该路由的 chunk,首次加载 JS 从约 108 KB 涨到 238 KB。任务卡写明为什么值得:一次性可缓存的静态 JS,换掉的是每次请求重新生成的约 1.1 MB 动态载荷。
R-WEBFETCH 的病态输入。 五种恶意正文(超长嵌套、二十多万个开启符等)在消毒器上的耗时,修后全程不超过 0.64 秒;抽取库在 256 MB 地址空间限制下最坏 125 MB。这些数字决定了「预研时定的元素数与深度上限要不要加」——量出来不需要,就不加。
R1 的内存基线。 第 11 章讲过。
四个例子的共同点:测量方法写在任务卡里,别人可以重跑。
不是所有验收都能在本机做。项目里有几种处理:
用假的上游驱动真实的内核。 本机开发库里没有配任何模型 provider,任务卡里「本机配好一个能跑的 provider」这类前置默认不成立。做法是起一个本地的假模型服务,按提示词关键字回固定剧本,配置成一个 provider——agent 内核、工具、轨迹、落库、SSE 全是真的,只有模型回复是假的。R-TOOLCARDS 用这个办法跑通了五个剧本(文本→工具→文本、工具出错、入参含凭据已脱敏、超长入参截断、无工具),并用刷新前后会话区 HTML 的哈希一致来证明回放正确。
交接,并写明交接给谁、何时验。 R-VISITOR 的「新建会话首帧带 Set-Cookie」本机验不了(开发反代的行为不同),任务卡写「交接 130 预发实测」,预发升级当天验掉,留证写回任务卡,进度表那一行加一句「不再交接给 R11」。R-WEBSEARCH 的端到端本机没有凭据,交接生产,生产首发当天实跑通过。
「未验」也要写。 R-SKILLS 发版留证的最后一句:「未验:SSE 全链路(本次 diff 未触 agent 运行代码,只加了迁移与测试)。」写「未验」比不写更有价值——读者知道这一块没有证据,而不是误以为验过。
部署文档里有一份冒烟清单,每次发版逐项跑。它不是一次写完的,每轮往上加:
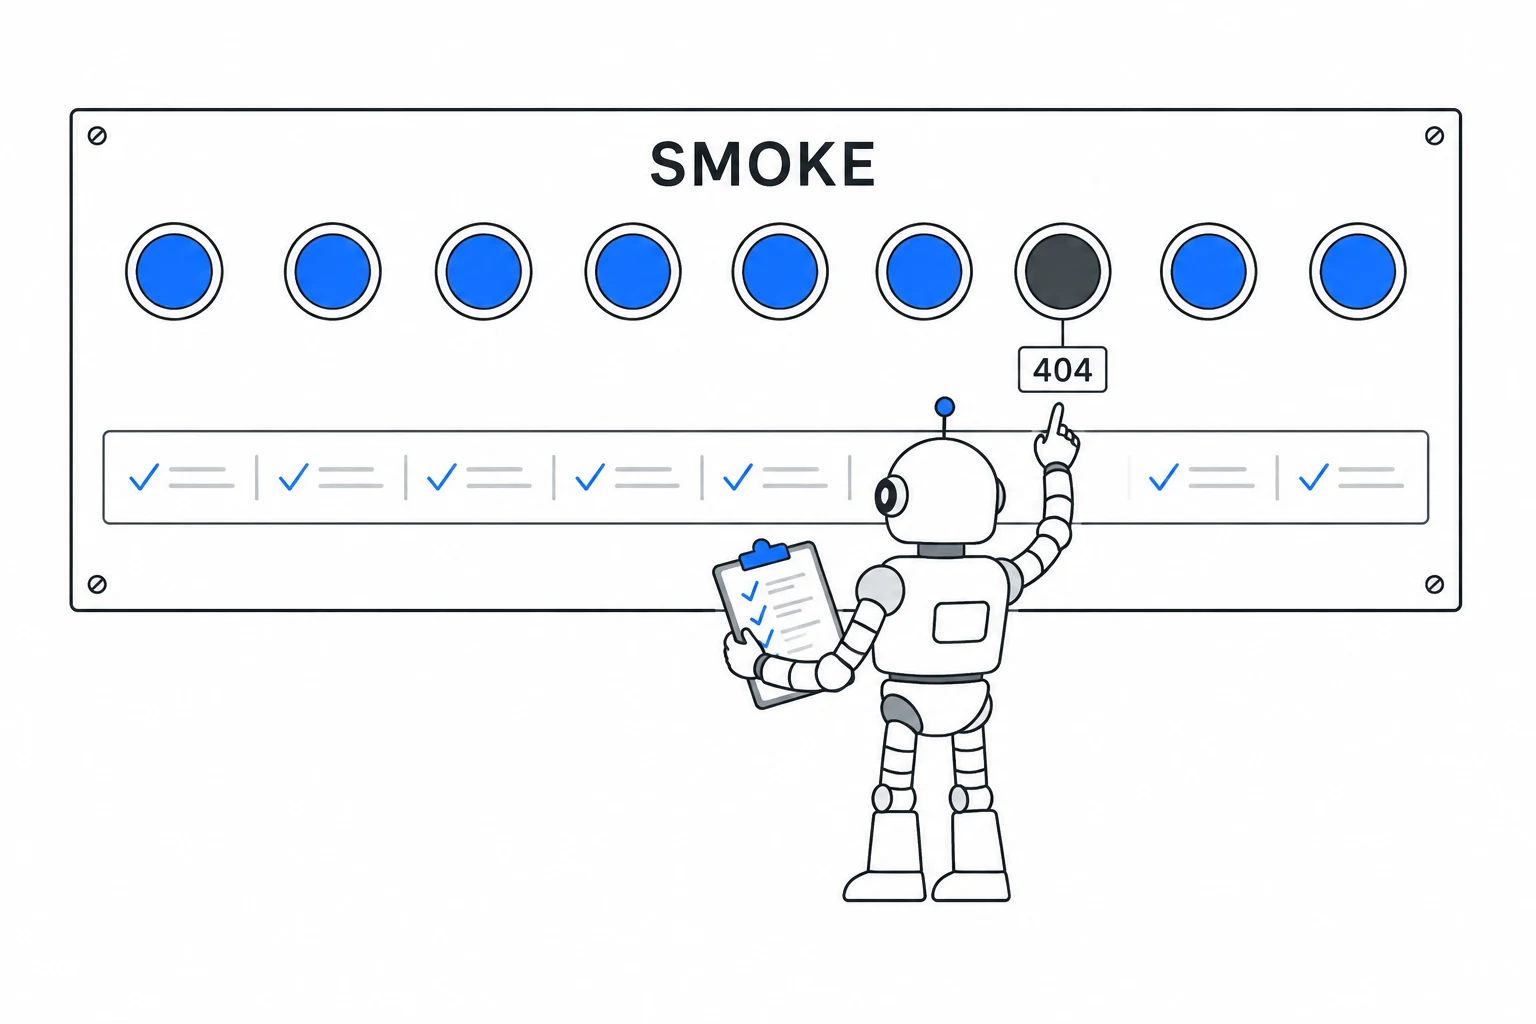
一排指示灯,每盏对应一条检查。灭的那一盏下面写着 404。
几条有来历的:
第 1 条:各服务各取一个正式端点,全部非 404。 来历是构建脚本的服务白名单是维护热点——每加一个服务都要补一次,漏补的表现是该服务端点静默 404。R-TABS 漏补了新加的服务,按那个提交构建会整站 500 级。这条检查后来从七个服务扩到九个。
第 4 条:管理面协议判据。 发现接口回的支持版本必须是要求的那个。请求体形状照另一份留证抄,逐请求四件套缺一样就是 4xx;命名空间前缀少一个键,处理器会静默落到旧协议路径,看起来像端点坏了。
第 12 条:运行时判据。 三条:运行时版本变量有值、真实的旧运行时可执行文件不存在、包管理器里没有旧运行时的包。不能用某个常见命令去验——基座自带一个指向新运行时的软链,按它判会得出错误结论。
第 19 到 21 条:执行容器隔离。 R-SKILLS-2 加了第 19 条(容器内连不出网、根文件系统只读、清单外脚本名被拒),第 20 条(端到端),R-WEBFETCH 加了第 21 条(出网实例只在专用网络、解析不到内部容器名、内网地址被拒、公网可达)。
清单是活的:每轮加的那几条,就是那一轮引入的新风险面。
验证会失败,判据也会失败。项目里三次:
用例选错了环境。 R-WEBFETCH 任务卡的验收用例是抓一个维基百科页面。生产实跑失败——服务器在境内,那个域名解析到一个不是维基的地址。模型按 skill 文档降级,说明读不到并用自身知识回答。留证写了一句:「这条用例不适合当生产验收判据,换境内可达的页面。」同一次冒烟还发现两个常用的公网地址在境内不可达,不能拿来当存活探针。
判据的覆盖面比想的窄。 R-PERF 先写了页面级的错误边界,本机停掉后端复现「后端不可达」时它没生效——错误边界只兜住自己的子树,兜不住同段布局自己的错误,而布局每次请求都要打一次后端。这是只有跑起来才发现的缺口。
防线的覆盖面比想的窄。 宿主出网过滤写在转发链上,容器发往宿主自身地址的包走的是另一条链,六条规则看不见。规则没写错,是覆盖面少了一类目的地。
三次的共同处理:改判据或记缺口,不改结论。 维基那条换用例;错误边界补一层;过滤缺口记 BACKLOG 并写进发布记录。没有一次是「反正差不多,算过了」。
证据要留在能被找到的地方:
留证的反面是「我记得验过」。项目里有一条 BACKLOG 就是这么来的:某次验收的输出被截断,脚本在删除前收到信号退出,一条测试会话留在了生产库里——留证写了它的 id 和为什么没删。
自动化门禁不是全覆盖的。项目的两条门禁命令都不跑完整的类型检查——两者全绿而类型检查报两条错。这不是构建阻塞,但意味着类型错误只能靠 IDE 或人工发现。修法属于新增机制,记 BACKLOG 等裁定。
知道门禁的盲区在哪,比假装门禁全覆盖更安全。
只看 agent 的总结。 「功能已完成」后面没有命令与结果。
抽查代替全量。 影响全站的改动只看了三篇。R-PERF 的 281 篇就是为了避免这个。
判据错了改结论。 用例在这个环境跑不通,就说「算过了」。
留证缺失。 三天后没人知道那一轮验了什么。
「未验」不写。 读者以为验过。
把自己项目的「完成」改写成一张冒烟清单:每条一个命令、一个期望值。然后找出其中哪些条在本机验不了,为它们写「交接给谁、何时验」。最后加一行「未验」,写这次发布没有证据的那一块。
 苏公网安备32011402012723号