核心观点 一个公开可访问、访客能与 agent 自由对话的站点,威胁模型必须先于功能。安全文档是强约束,改动先改文档再改代码。核心思想是「兜底不在检测,而在能力」:让危险的事在工具的词汇表里表达不出来,比过滤字符串可靠。供应链同理:钉版本、锁哈希,升级可能破坏硬约束时先告知所有者。
Agent X-Ray 的安全文档第一句话:「本文是实现与部署的强约束,不是建议。任何违反沙箱规则的改动都必须先改本文并说明理由。」
这句话写在项目第一天,那时站点还没有一行业务代码。原因很简单:站点公开可访问,访客可以与嵌入后端进程的 agent 自由对话。这个前提决定了一切——每一个访客都可能是攻击者,每一段模型读到的文本都可能是注入。
威胁模型是一张会长的表。开工时四条,到 2026-09-04 九条,每条带轮次代号与裁定日期:
| # | 威胁 | 何时加入 |
|---|---|---|
| 1 | 访客借 agent 触达服务器:执行命令、读写文件、改配置 | 开工 |
| 2 | 凭据泄漏:LLM key 经事件流、前端、Git 外泄 | 开工 |
| 3 | 资源滥用:刷爆费用、OOM、把服务器当代理 | 开工 |
| 4 | 管理面被攻破:token 泄漏、暴力猜测、审计缺失 | 开工 |
| 5 | 外部内容注入:搜索结果是不可信的第三方文本,会原样进模型上下文 | R-WEBSEARCH |
| 6 | 代码执行:访客经模型驱动一个解释器跑固定脚本 | R-SKILLS-2 |
| 7 | SSRF,经沙箱出网:访客给一个 URL 让容器去抓 | R-WEBFETCH |
| 8 | 经 URL 外泄:注入页诱导模型把对话内容拼进 URL | R-WEBFETCH |
| 9 | 第三方资源引用进对话框:抓到的图片引用被模型抄进回复 | R-WEBFETCH |
每次给 agent 加一种能力,威胁模型先加一条。R-SKILLS-2 让 agent 能跑脚本,威胁 6 先写;R-WEBFETCH 让 agent 能抓网页,威胁 7、8、9 先写。功能进轮次之前,它带来的威胁已经有名字了。
威胁 5 的原文里有这个项目安全设计的核心句子:「兜底不在检测,而在能力——被注入的模型能调用的只有那几个只读工具和另一次同样受限的搜索,做不成任何有副作用的事。搜索结果不做指令过滤:那是一场打不赢的字符串仗,而能力边界是可证明的。」
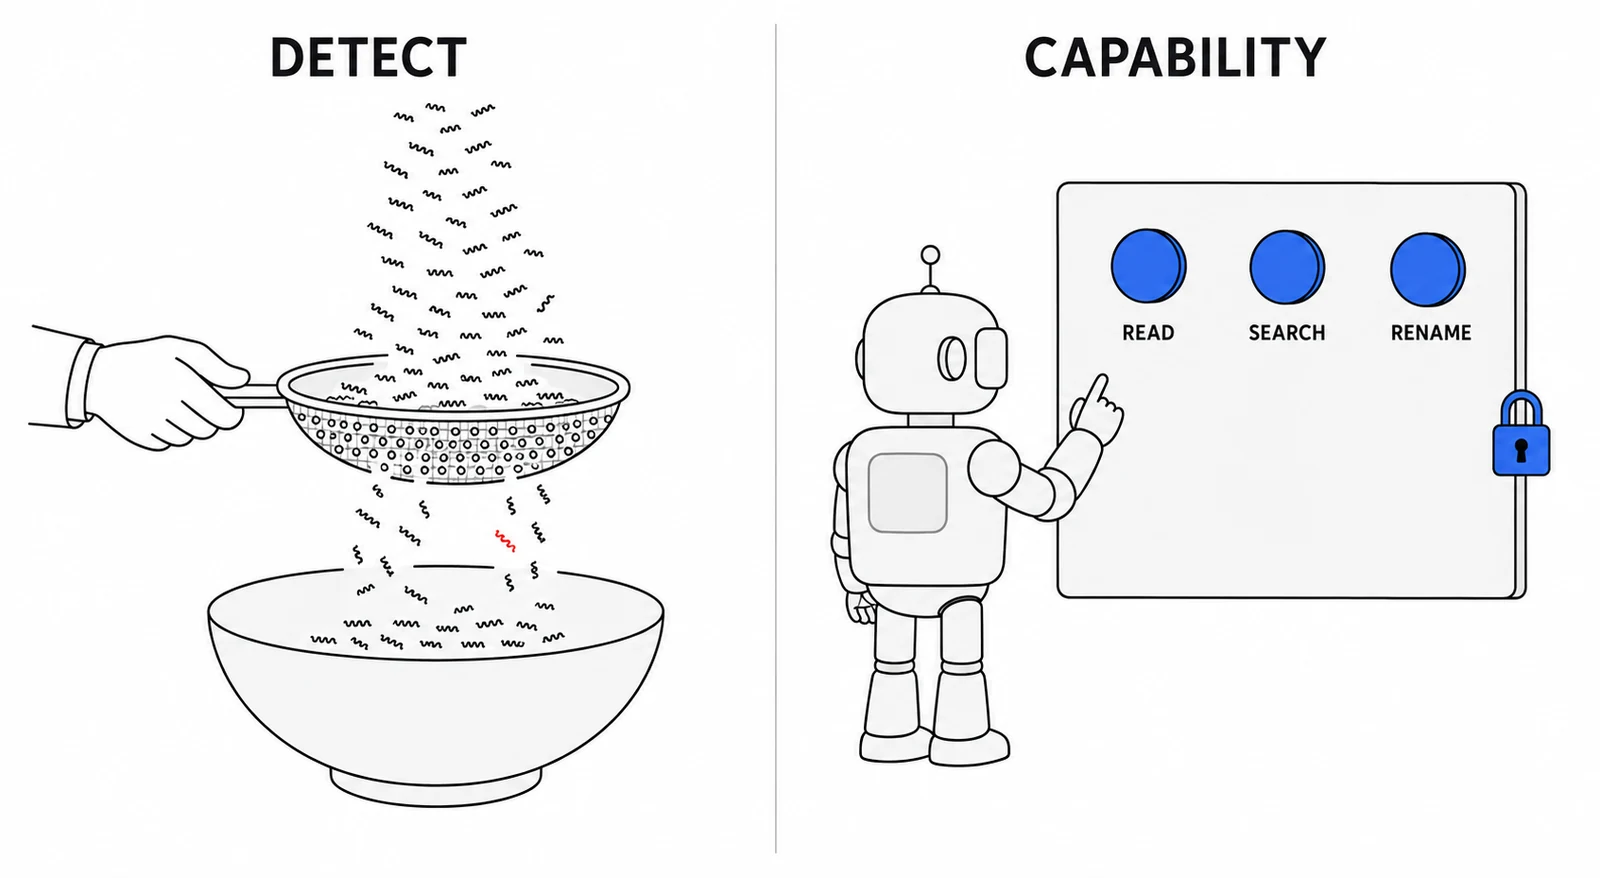
左边:用筛子过滤文本,总有漏网的。右边:面板上只有三个按钮,按什么都出不了这三件事。
这个思想在项目里有一个更具体的表达:让危险的事在工具的词汇表里表达不出来。
对比一下另一条路:写一个过滤器,识别「忽略前面的指示」这类句式。这条路的问题不是做不好,是永远做不完——第 14 章那个七轮消毒器就是走上这条路的结果。
安全文档把隔离分成四层,每层挡的东西不同:
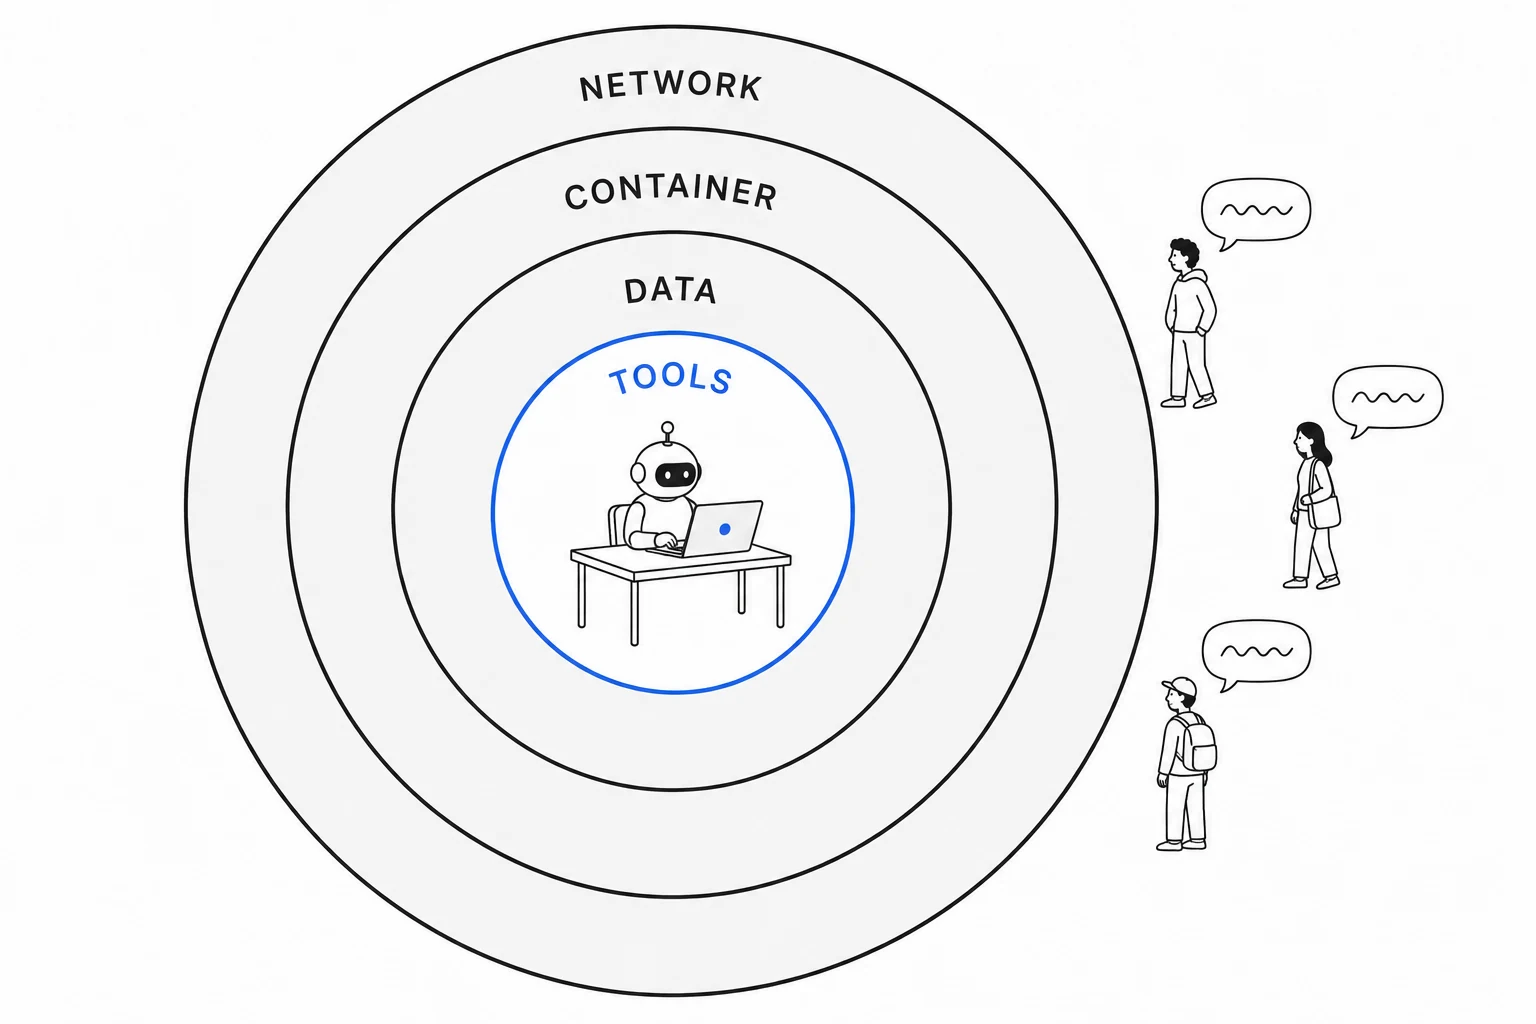
由内向外:工具白名单、数据面只读、容器隔离、出网管控。访客在最外面。
| 层 | 机制 | 挡的是什么 |
|---|---|---|
| 工具白名单 | 内置工具全关;业务工具逐个注册,集合由配置表决定;执行类工具双闸 | 访客借 agent 触达服务器 |
| 数据面只读 | agent 走只读数据库角色;写工具走专用角色、列级授权、只能写本会话那一行 | 借工具改数据 |
| 容器隔离 | 只读根文件系统、去掉全部特权、进程数与内存上限;执行容器每次一次性进程与工作目录 | 逃逸与资源耗尽 |
| 出网管控 | 目标域白名单在代码里、env 只能追加不能替换;执行容器默认无网络;出网实例只在专用网络、拒固定内网地址段 | SSRF、把服务器当代理 |
四层是叠加的。工具白名单漏了,数据面只读还在;数据面漏了,容器隔离还在。R-WEBFETCH 的 SSRF 防线就是三层各在各的位置:脚本逐地址校验并钉住地址去连、容器不在任何内部网络里、宿主防火墙对该网段丢弃到私网的包。文档里的原话:「让『脚本有 bug』不等于『内网可达』。」
安全文档最初写「每个工具必须是纯函数」,后来发现与第四层「外呼型工具」自相矛盾——外呼工具必然要持凭据、发请求。R-WEBSEARCH 时把边界写死成一张表,之后扩到四组:
| 组 | 成员 | 网络 | 凭据 | 写库 |
|---|---|---|---|---|
| 纯函数组 | 内容查询、skill 加载 | 无 | 无 | 无 |
| 外呼组 | 联网搜索、生图 | 仅目标域白名单内的固定端点 | 服务端持有,只在进程内流动 | 无 |
| 会话绑定组 | 会话命名 | 无 | 无 | 只写本会话那一行的限定列 |
| 沙箱执行组 | 脚本运行 | api 进程到执行容器只有一条 unix socket | 无 | 无 |
外呼组有六条附加约束,「缺一条就不许注册」。挑三条最有代表性的:
第三条是审查抓到的另一条 P1,也是「文档与代码强一致」的反面教材:约束写了,但写在一个不生效的位置。
威胁 2 的防线是脱敏。项目里的口径有几条:
逐事件字段白名单,不是黑名单。 R1 审查的第一条 P1。黑名单是「删掉已知的凭据字段」,漏一个就泄一个;白名单是「只放行已知安全的字段」,未列的一律丢弃。整改后 provider 相关事件只剩类型与状态两个字段。
采集点即脱敏点。 事件在观测者里就过白名单,库与 SSE 拿到的都已是脱敏数据。架构文档的原话:「入口脱敏比出口再洗一遍更强,否则库里会留着原文。」
凭据在构造错误的地方就抹掉。 R-WEBSEARCH 测试抓到的真 bug:上游 4xx 的响应体被原样放进错误对象,而网关会把请求头回显进错误体,明文 key 就进了一个会被传递、被别处 catch、将来被人直接打印的 Error。只在日志那一行脱敏是不够的。而且通用模式(前缀匹配)兜不住纯十六进制的自定义网关 key,必须再叠一道本次 key 的精确替换。
key 加密入库,任何读回只给掩码。 包括管理面工具的返回值——那会进管理面客户端的模型上下文,掩码必须在服务端完成。加密选认证加密,让「库被改一个字节」直接解密失败,而不是解出一段垃圾 key 去打 provider。
加密密钥不能跟 token 一起换。 管理面 token 丢了可以轮换,服务端只存哈希;但加密密钥换了,所有 provider 的 key 密文全部作废,agent 立刻停摆。这条写在部署文档、任务卡和 CLAUDE.md 三处。
执行类工具默认锁定,开启需要两道闸:服务器环境变量加管理面开关。任何一道没开,工具就不注册。所有启停操作写审计日志。
与双闸配套的是止损路径,而且止损不发版:管理面关掉一个工具,当场停用;关掉一个 skill,单个下线;停掉执行容器,该 skill 的调用以固定文案失败,其它 skill 与站点照常。R-WEBFETCH 发版当天做了止损实测:停容器后调用三毫秒快速失败,起回来立即恢复。
止损的意义是让「放开一种能力」的决定可逆。所有者敢裁定「做」,部分原因是知道随时能关。
规则 9 的顺序在每一轮都执行。以进行中的 R-USAGE 为例:
要把会话累计 token 送到前端,与安全文档里「收尾帧不带 token 数」直接冲突。处置顺序是:任务卡先写「与安全文档的冲突及处置」;安全文档追加补记,写明放开的只有两个聚合数(会话累计 token、上下文占用百分比)、仍然不出服务端的是什么(费用、模型与 provider 名、上下文窗口绝对值、分轮次明细、限额与用量)、已认的风险(第一轮结束时能粗略反推上下文窗口量级,所有者认下,理由是个人站量级下不构成配置泄露);然后才动代码。
审查在这一轮抓到一条 P2 也与顺序有关:落库与发帧的先后——反过来的话访客看到顶栏更新后立刻刷新,会读到上一轮的库值,数字当着面回退。修法是先落库再发帧;落库失败时帧照发,不为这个偏差新增补偿机制。
安全约束的另一半是供应链。项目里每个关键依赖都钉死,而且钉的方式有讲究:
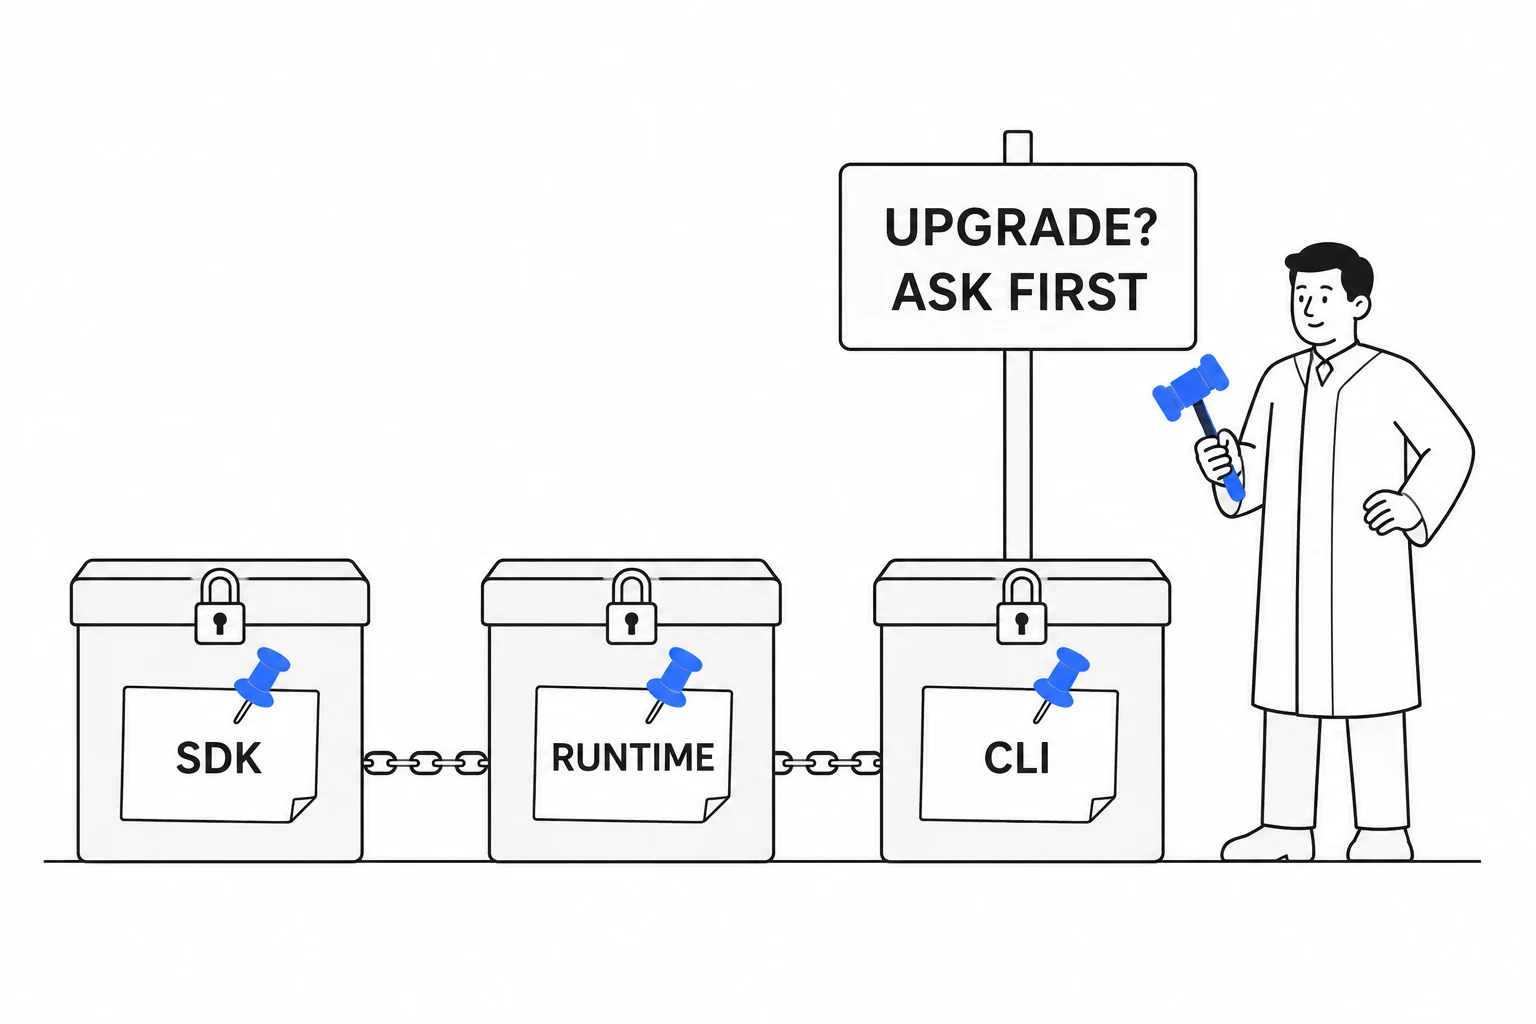
SDK、运行时、命令行工具三者钉死并锁在一起;升级前先问。
| 依赖 | 怎么钉 | 为什么 |
|---|---|---|
| agent 内核 SDK | 精确版本,lockfile 固定 | 升级前要重跑 34 事件兼容性 |
| JS 运行时 | 四处同版本:两个镜像基座、构建脚本、包管理字段 | 漂移的表现是测试环境与生产不一致 |
| 管理面 SDK | 精确版本,且是 v2 的新包名 | 旧包最新版不支持要求的协议 |
| 框架命令行 | 钉住,升级前确认实验位未改名 | 同机另一个项目共用守护进程 |
| 执行容器基座 | 按 digest 钉 | tag 会漂 |
| Python 依赖 | 每行精确版本加哈希,可选依赖不装,装完删掉 pip | 镜像站只是下载来源,哈希照核 |
两条规则把钉版本变成硬约束:
规则 11:开实验位与换基座必须成对出现。 只开运行时实验位不换镜像基座,会产出一个必然启动失败的镜像——构建工具把入口改成了新运行时,基座却还是旧的。实测踩过一次,写进规则时附带了判据:别用某个常见命令去验镜像里有没有旧运行时,基座自带一个指向新运行时的软链,按它判会得出错误结论;正确判据是三条,写在冒烟清单里。
规则 12:升级只要可能破坏两条硬约束,必须提前告知所有者。 生产的两条硬约束是 JS 运行时与管理面协议版本。任何依赖升级只要可能让其中一条不再满足——实验位改名或移除、SDK 新版本不再提供该协议——必须在动手之前向所有者做风险告知并拿到裁定,不得在轮次内自行降级或绕过。
第 03 章讲「最佳实践不能照搬」,这里是它的具体形状:框架的默认构建流程在这个项目里会产出坏镜像,所以要有自己的判据。
安全设计不是消灭所有风险,是把接受的风险写出来。项目里的残余风险清单:
第三条值得注意:它是在生产冒烟时才发现的,而不是设计时。发现之后的处理不是掩盖,是写进发布记录与 BACKLOG,让下一个改这一块的人知道。
为自己的 agent 产品写威胁模型的前三条。每条写清:攻击者是谁、入口在哪、兜底在哪一层的能力边界(不是哪个过滤器)。然后检查:有没有一件危险的事,是当前工具的词汇表能表达出来的?
 苏公网安备32011402012723号