核心观点 在 AI Native 的工作系统里,人不写代码、不审代码,做三件事:裁定取舍、认下代价、承担偏离。裁定的输入是冲突清单而不是对话,裁定的输出落进文档而不是留在聊天记录,偏离流程要留痕而不是默认「审查通过」。人做的事变少了,每一件都不可让渡。
第 06 章的角色表里,所有者那一行的「做什么」只有短短一句:裁定、验收、认下代价。这一章把它展开。
在 Agent X-Ray 的八天里,所有者没有写过一行业务代码,也没有逐条读过审查 findings。所有者做的事在仓库里留下的痕迹是「裁定」两个字:ROUNDS.md 里十次边界修订、各轮任务卡里的裁定表、安全文档里逐轮的补记,还有 BACKLOG 里那些「所有者裁定不做」的条目。
三件事各有形状:
三件事里没有「指挥实现细节」。所有者不决定用哪个库、怎么写循环、变量叫什么名字。那些是实现 agent 的事,由审查 agent 做门禁。
所有者不可能读完每一轮的全部代码再做决定。裁定要高效,输入就必须是结构化的。项目里长出来的形式是冲突清单:
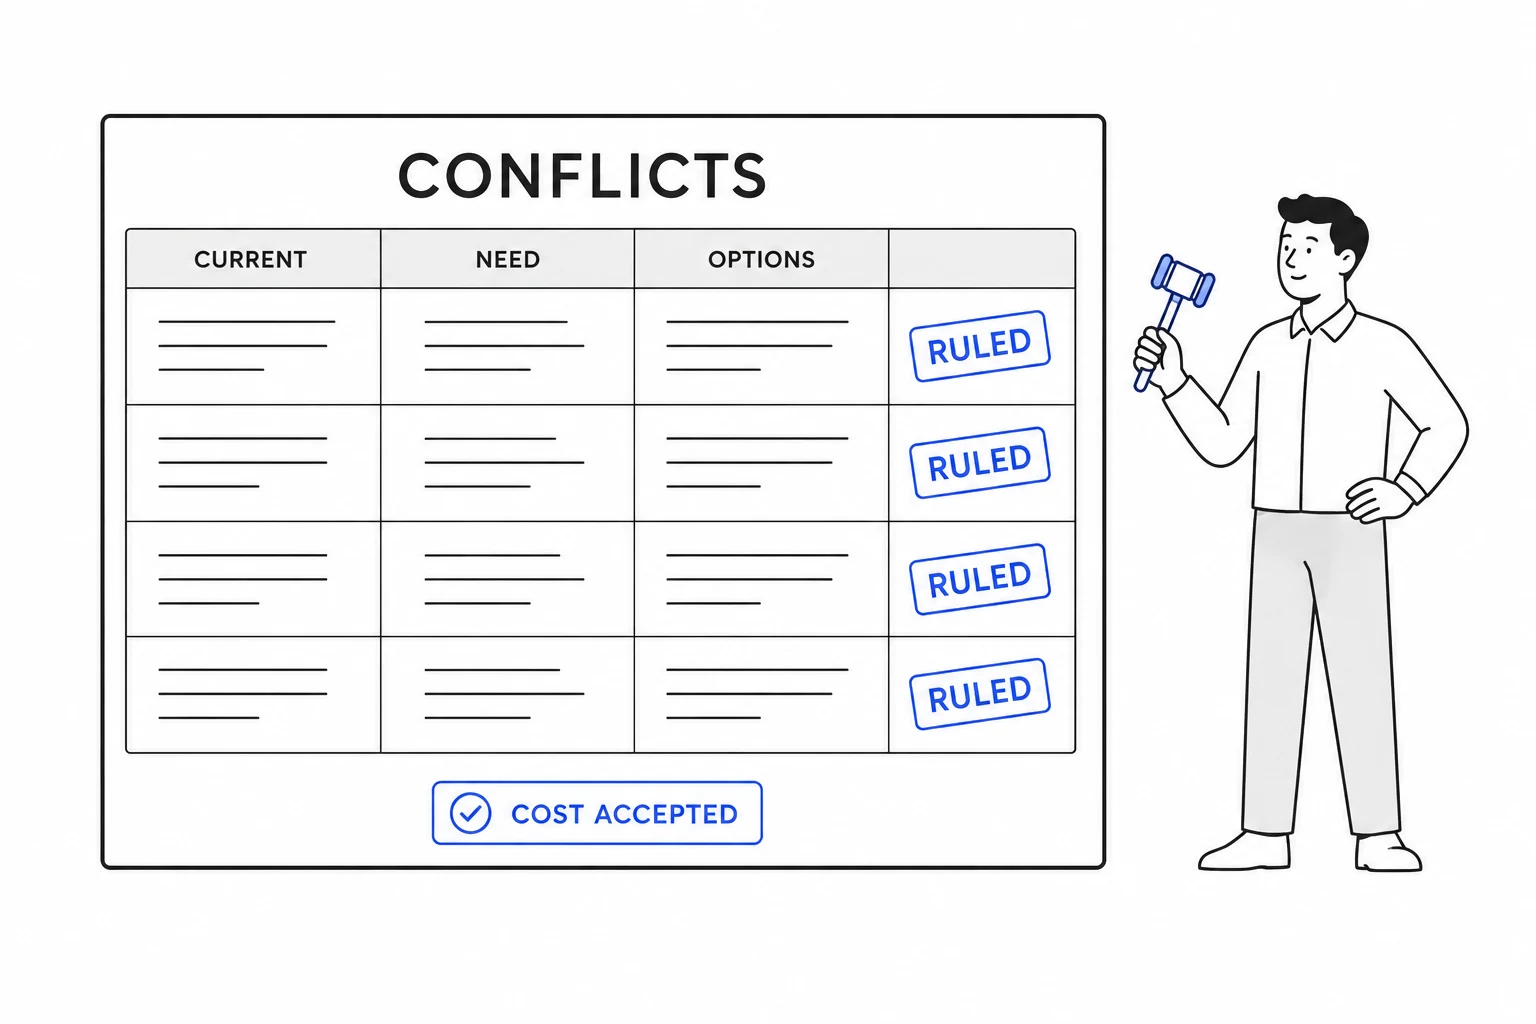
每一行是一个冲突:现行文本写的是什么、本方案需要什么、有哪些选项、建议哪个。所有者逐行盖章,并在下面认下代价。
以 R-WEBFETCH 为例,任务卡第 3 节列了十条冲突(C1–C10),每条五段:
| 段 | 内容 |
|---|---|
| 现行文本 | 引用安全文档、CLAUDE.md、既有任务卡里与本方案相抵的原话 |
| 本方案需要 | 一句话说明为什么非改不可 |
| 选项 | 两到三个,每个写代价 |
| 建议 | 实现 agent 的推荐 |
| 落点 | 裁定后要改哪些文档的哪一段 |
比如 C3「白名单原则 vs 地址黑名单」:现行文本是安全文档里「目标域白名单在代码里」;本方案需要开放网页,目标域不可枚举;选项是「开放 + 地址段黑名单」或「域白名单模式」(零 SSRF 面,但模型不知道哪些域可抓,利用率极低);建议前者。所有者的裁定原话被记进任务卡:「访客提供的 URL 不设限,域名黑白名单不做,太多了无法维护」,并确认「要拒绝内网地址段」。
十条裁定一次做完。所有者花的时间是读一张表,不是读一个方案。
同样形式的裁定在项目里反复出现:R-SKILLS-2 的七条(做不做、规则措辞、画板先改、容器通信方式不通就停、默认只展示不注入、改可用 skill 等于发版、预发非必经);R11 备案通过后一次裁的五条;R5 内容摄入方案的逐条裁定表。它们的共同点是:实现 agent 先把冲突找全、把选项列全,所有者再裁。
裁定的必要部分不是「选了哪个」,而是「认了什么代价」。项目文档里「代价已认」「所有者已认」这几个字出现得很频繁:
为什么要把代价写出来?因为不写,代价就会在几周后以「怎么会这样」的形式出现,而那时没人记得当初是有意接受的。写下来,后续的审查者扫到同一处时也不必重新裁定——BACKLOG 里有一类条目就是干这个的。
所有者的裁定在对话里说出来之后,实现 agent 的第一件事不是改代码,是改文档。这是 CLAUDE.md 规则 9 的顺序:安全文档是强约束,改动先改文档并说明理由。
裁定落的地方:
R-USAGE 是一个小例子:要把会话累计 token 送到前端,与安全文档里「收尾帧不带 token 数」直接冲突。任务卡先写了「与安全文档的冲突及处置」一节,在安全文档里追加补记写明放开的只有两个聚合数、仍然不出服务端的是什么、已认的风险是什么,然后才动代码。
留在对话里的裁定会消失:agent 没有跨会话记忆,人也会忘。落进文档的裁定会被下一个会话的 agent 读到,会被审查者当作判据。
流程可以被所有者越过。但越过要留痕,让「没做」这件事本身可查证。
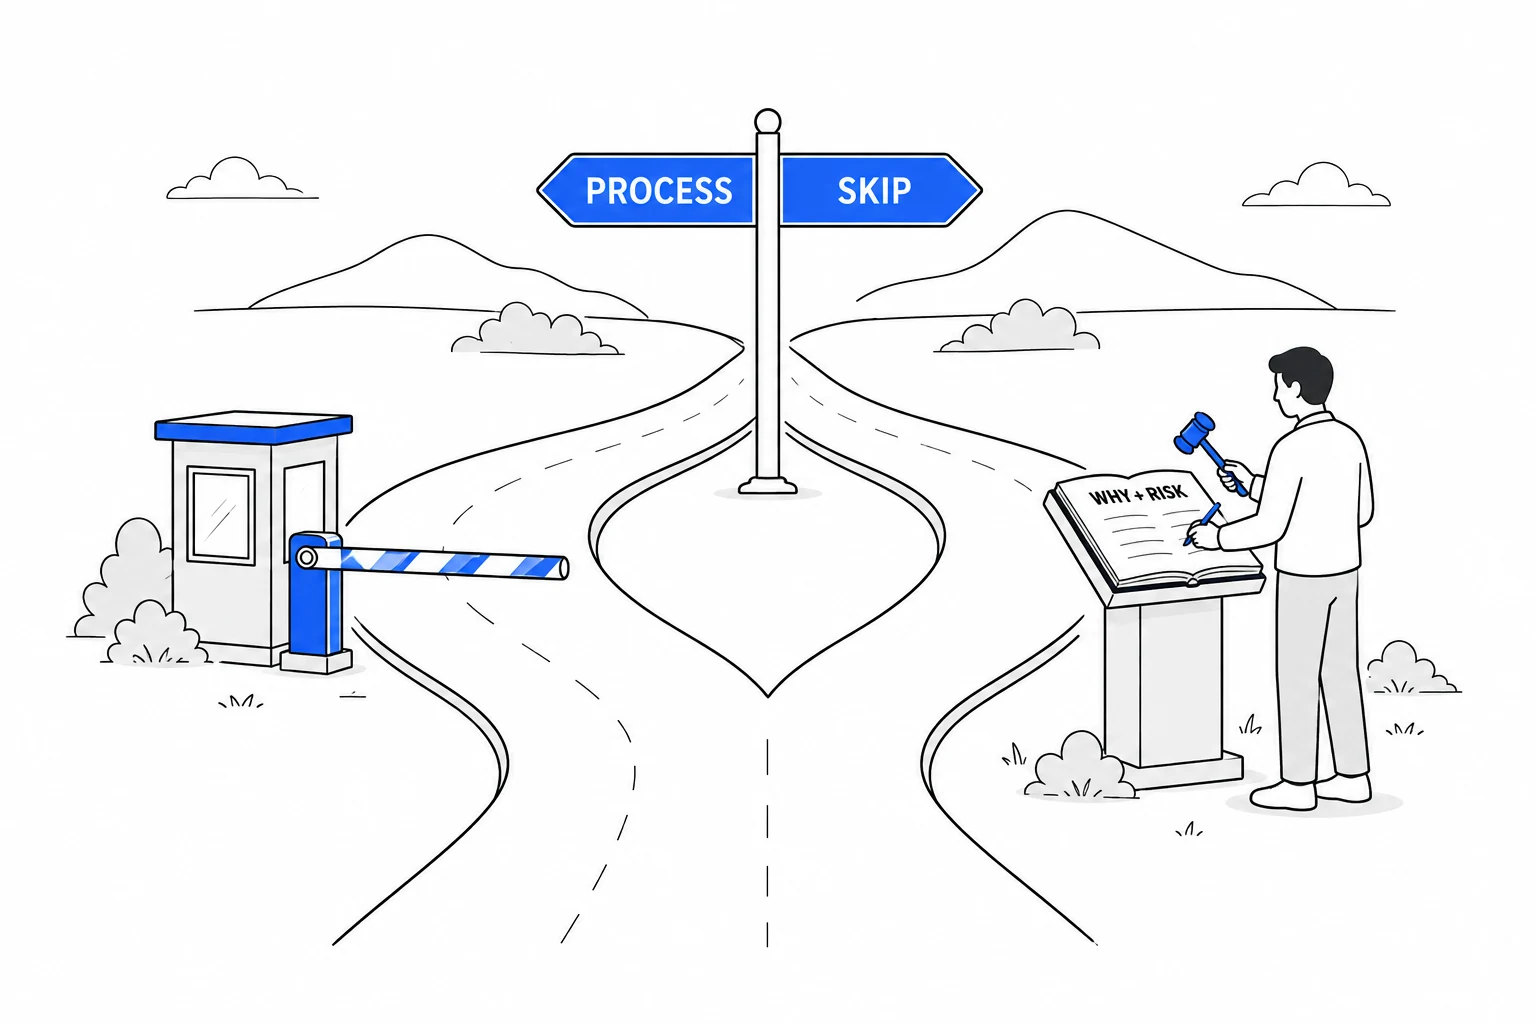
走流程要过门禁;跳过流程也可以,但要在登记簿上写下为什么和风险是什么。
三个例子:
R9 跳过审查。 实现 agent 已经发起了审查,所有者在运行中提出「没改代码为什么要审查」。实现 agent 给出反驳:九百多行新增里约六百行是文档,代码与脚本约九十行,分布在四处,并指出最值得被人看一眼的两处(部署脚本拼命令行且要处理含中文的路径;迁移脚本在部署必经路径上)。所有者据此仍裁定跳过。任务卡的「代码审查」段这样收尾:「本轮无审查记录。这是与流程的一次显式偏离,记在此处以免将来被误读成审查通过。残留风险:两处改动只经过本轮实跑验证,没有第二双眼睛看过错误分支与边界情况。」
R11 收工四项不做。 上线当天所有者裁定收工时不做:上线检查单在生产重跑、codex 审查、token 轮换演练、首日观察。任务卡「收工」段逐项写了代价——检查单在预发全绿但生产只做了部署冒烟,差的六项列了出来。
R10 不做限额演练与备份。 所有者裁定不做,记 BACKLOG。后来 R11 的验收里「限额演练不适用」引用的就是这条裁定:所有者裁定生产不设限额,超限路径无从演练,以预发的留证为准。
留痕的形式很朴素:一段文字,写清「谁裁定的、为什么、代价是什么」。但它让后来的人能区分「验证过」和「决定不验证」,这两者对风险评估的意义完全不同。
所有者不在实时回路里。一个好的实现 agent 不会每遇到一个问题就停下来问,而是:
R-WEBFETCH 任务卡的第 4 节就叫「沿用预研的待裁定项(默认建议;无异议即按默认)」,列了八项——http 是否降级、重定向几跳、robots 是否遵守、图片怎么处理、上界多少——每项一个默认值。所有者只需要对不同意的项说话。
反过来,有些问题必须停下来问,不能按默认:改变已裁定过的形态、新增机制、触碰安全边界、需要凭据或生产权限。R-SKILLS-2 的研究文档里写着「spike 不过 → 不进 2.0,回所有者重裁,不自行退到共网」——通信方式不通时的处理不是找替代方案,是停下。
审查 agent 报的 findings 不是最终裁决。所有者可以不采纳:
不采纳的条件是写明理由。审查者的判断是「这里有缺陷」,所有者的判断是「这个缺陷在当前边界下可接受」,两者不矛盾,但后者的理由必须能被下一个审查者读到。
裁定不只针对方案,也针对 agent 的工作方式。项目里有几次所有者当场纠正实现 agent:
这些纠正的去处是记忆文件,不是对话。每条记忆写清现象、为什么错、下次怎么判断。第 20 章讲记忆的分层与写法。如果纠正只留在对话里,下一个会话的 agent 会再犯一次,所有者会再纠正一次——那是最浪费的循环。
把上面的实践收成一张表,可以直接用:
| 列 | 写什么 |
|---|---|
| 日期 | 裁定当天 |
| 问题 | 一句话,引用现行文本与冲突点 |
| 选项 | 两到三个,各带代价 |
| 建议 | 实现方的推荐 |
| 裁定 | 所有者的原话 |
| 代价 | 明确「已认」的是什么,包括残余风险 |
| 落点 | 要改的文档与段落;是否为规则的例外 |
这张表的每一行都是一个可以被引用的决定。半年之后有人问「为什么这里不做域名白名单」,答案不在某个人的记忆里,在表里。
为自己的项目建一张裁定登记表,用上面的七列。把最近一个月里所有「其实是决定但没人写下来」的取舍补进去,每条都写代价。看看有几条你现在已经说不清当初为什么那样选。
 苏公网安备32011402012723号