核心观点 审查循环里长出来的设计是最危险的设计:每轮补一块,下一轮在补的地方再找到一块。审查是缺陷门禁,不负责长出方案;findings 若指向设计缺陷,停下来回到所有者层面重定方案。判据是「是否新增机制」,不是 findings 的级别;连续两轮 findings 落在同一块自建机制上,就该停。
第 13 章讲了审查循环怎么跑:findings → 整改 → 复审,直到 high 级清零。这个循环有一个隐蔽的失败模式:它可以无限跑下去,而且每一轮看起来都在进步。
审查者报一条缺陷,实现者补一块;复审在补的那一块上再找到一条,实现者再补一块。每一条 findings 都是真的,每一次整改都能闭合那条 findings,测试也都绿。但六轮之后回头看,那一块代码已经从一行变成了一个解析器,而任务卡上从来没有写过要做解析器。
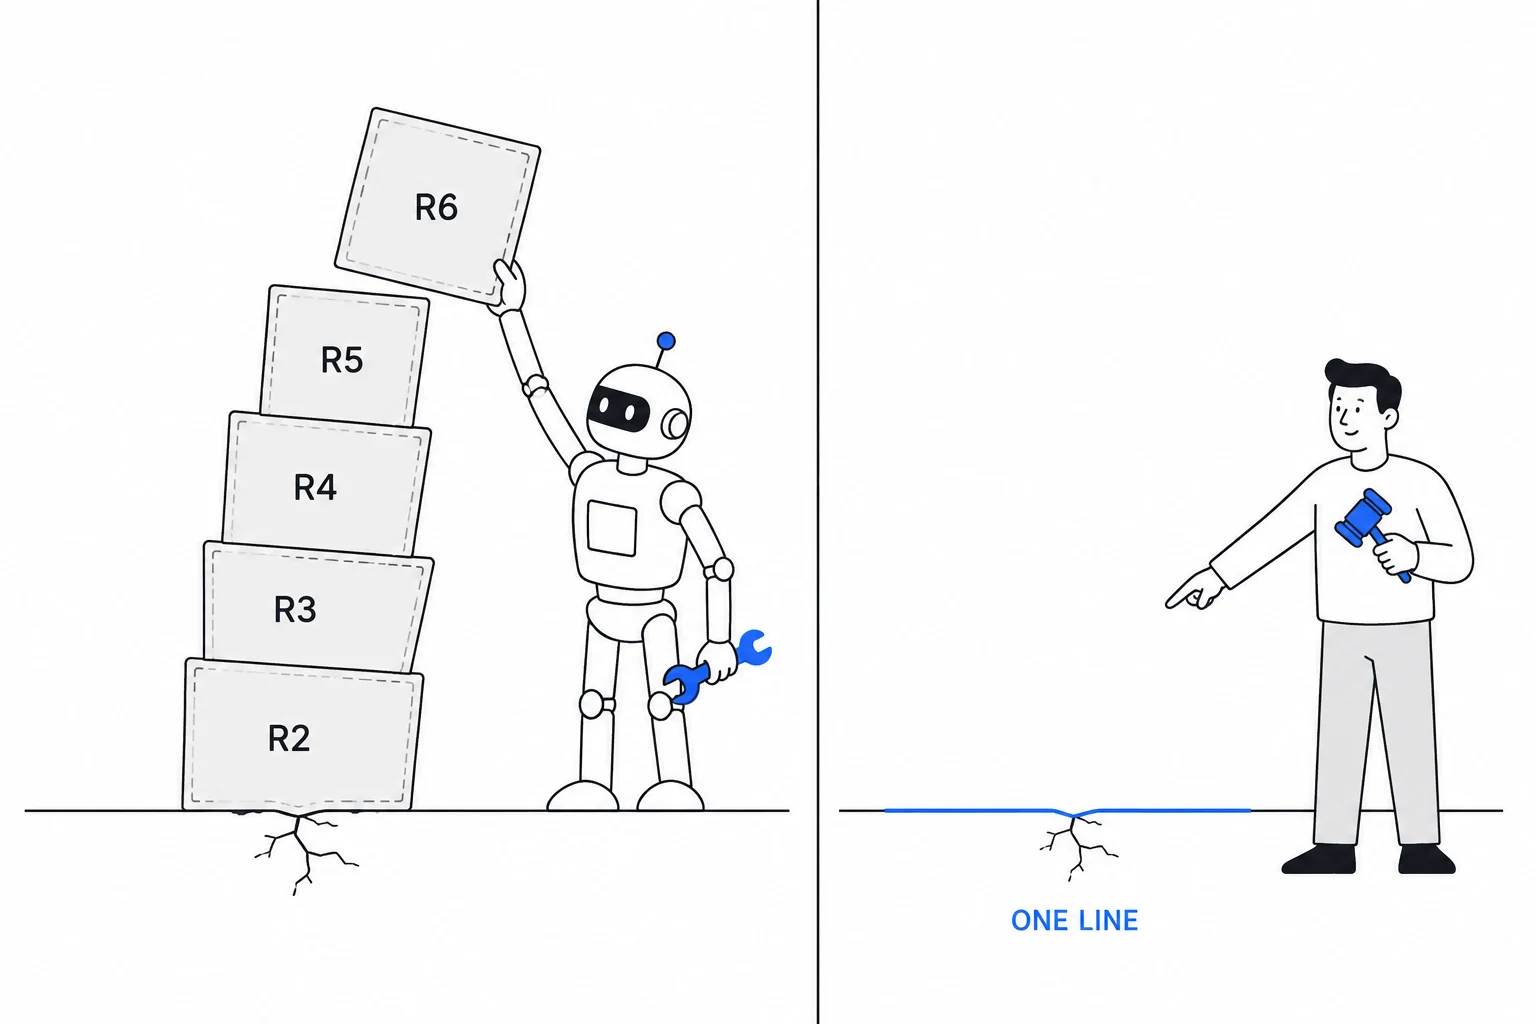
左边:每一轮在上一轮的补丁上再加一块,越叠越高。右边:所有者裁定后,同一道裂缝只用一条线。
这就是「以审查代替设计」。审查者没有做错什么——它的职责就是在当前代码里找缺陷。实现者也没有做错什么——每条 findings 都最小改动闭合了。错的是循环本身在替设计做决定,而设计的决定权不在这个循环里。
Agent X-Ray 的 CLAUDE.md 在 2026-08-28 就写下了「审查边界」,那时项目才开工第一天:
规则写得很清楚。但第一天写下的规则,到第七天还是被违反了一次——而且是在明知规则的情况下。下面这个案例值得完整地讲。
R-WEBFETCH 是让 agent 读访客指定网页的一轮:一个在隔离容器里跑的 Python 脚本,抓取网页、抽取正文、返回 markdown。安全文档的威胁模型里有一条(威胁 9):抓到的 markdown 若含第三方图片引用,模型抄进回复,访客的浏览器就会去拉第三方图——IP 泄露加跟踪像素。所以脚本要在输出里去掉图片。
第 1 轮(全量):4 条 findings,3 条 P1 加 1 条 P2,全是真缺陷——部署脚本漏传一个文件、Dockerfile 里 || true 吞掉了安装失败、元数据字段没过消毒、残缺的 gzip 流被当完整页面。全部采纳。
第 2 轮(全量):2 条。其中一条 P1:去图片的正则挡不住 alt 里嵌套方括号的形式。整改:把正则改成按括号深度扫描,并加一道兜底——扫完之后剩下的图片开启符一律转义。
第 3 轮(只审整改 diff):2 条。深度扫描器对 reference-style 图片的 alt 原样保留,内层图片漏出;且每个未闭合的开启符都从它扫到文末,恶意正文会让消毒变成二次方。整改:改为单趟栈式扫描。写线性时间用例时又抓到同类第三处(链接正则的无界量词),一并修了。
第 4 轮:1 条 P2。第 3 轮给链接正则加的长度上限成了旁路。整改:链接处理并进同一趟栈式扫描。
第 5 轮:1 条 P2。删除会制造新邻接——去掉外层非法链接后,内层文本与后面的括号拼成新链接。整改:加一个邻接守卫。
第 6 轮:2 条 P2。守卫倒着扫输出找最后一个非空片段,二次方;控制字符事后才删,守卫看的是原文。整改:不留空片段、控制字符前置。
到这里测试全绿,第 6 轮整改还没提交。所有者提醒了一句:「别忘了要求严禁以审查代替设计。」
回头看第 2 到第 6 轮:8 条 findings 全部落在任务卡里没有的一块——实现 agent 自己写的 markdown 消毒器。它从一个正则长成了「深度扫描 → 栈式扫描 → 链接并入 → 邻接守卫 → 守卫线性化 → 控制字符顺序」,每轮补一块,下一轮在补的地方再找到一块。其中链接 scheme 过滤根本不在威胁模型里(威胁 9 只讲第三方图片),却贡献了四轮里的大部分 findings。
实现 agent 向所有者列了三个选项:收缩为一行转义;保留栈式扫描器再审一轮;把边界挪到前端渲染层。所有者裁定收缩为一行转义。
新的实现只做两件事:去控制字符,把每个图片开启符 ![ 无条件写成 !\[。CommonMark 里被转义的方括号永远开不了图片——内联、reference、shortcut 三种形式都以 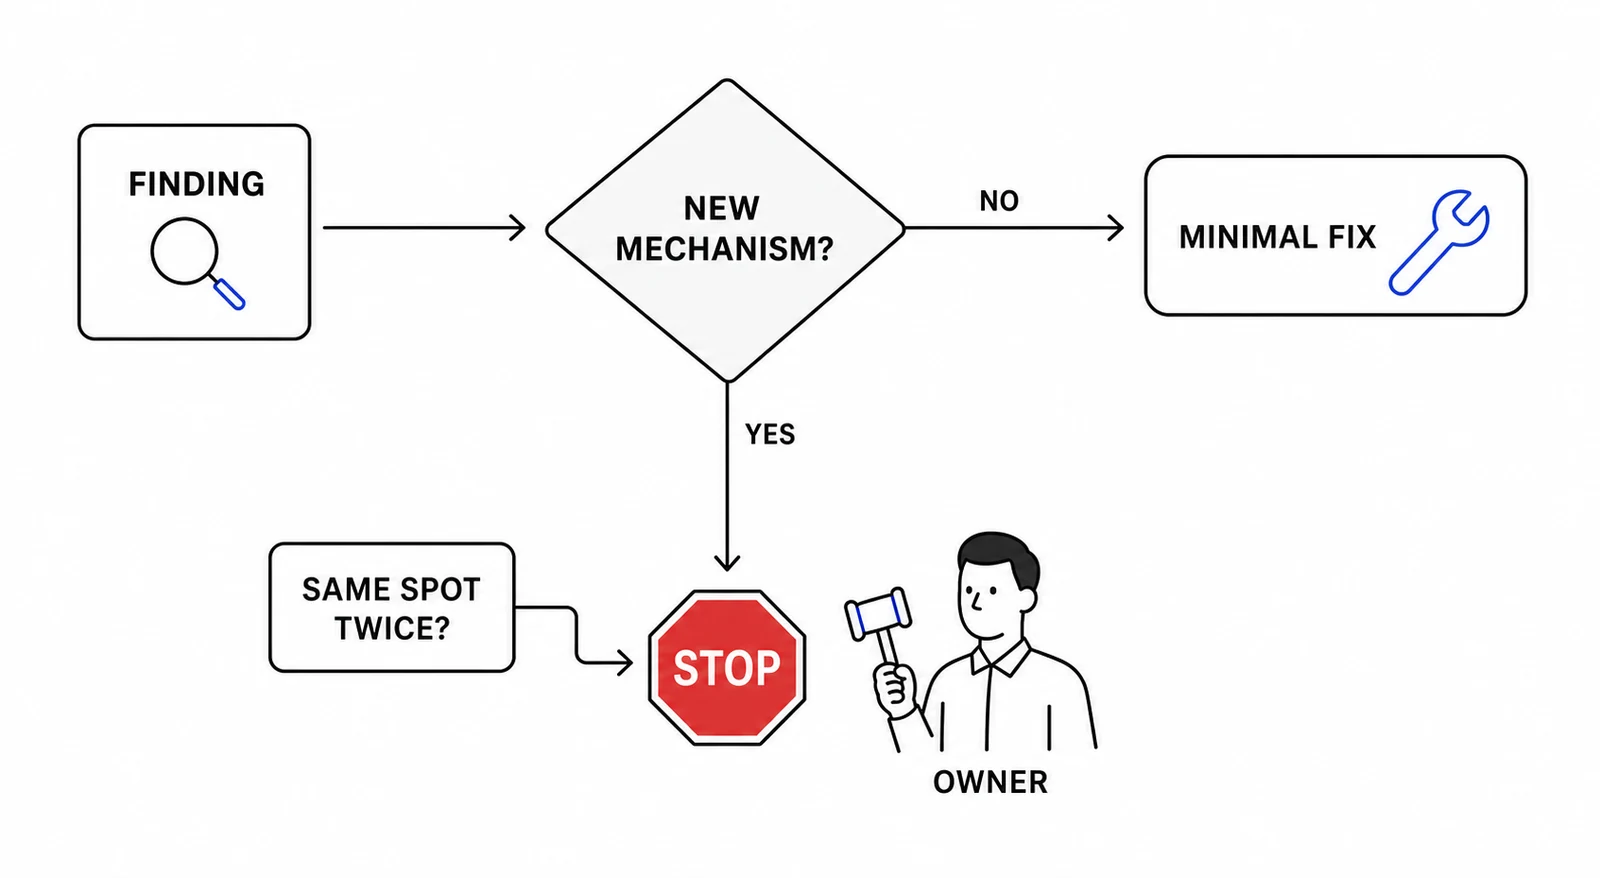
两个判据任一成立就停:修法要新增机制;或者连续两轮 findings 落在同一处。
停下来不是放弃,是换一个层面工作:
停下来的信号也要沉淀成记忆:连续两轮 findings 落在同一处、且那一处是任务卡里没有的自建机制(解析器、状态机、缓存、守卫),第二轮起就停,不发下一轮复审。项目里这条被写进了项目记忆,标着「所有者纠正」。
回看自己最近一次多轮修补的记录(不管是人做的还是 agent 做的),找出「审查在替设计」的那一轮:从哪一轮起 findings 开始落在同一块代码上?那块代码在最初的任务里有没有?写下当时应该停下来问所有者的那个问题。
 苏公网安备32011402012723号