核心观点 agent 读的第一份文档决定它后面所有行为。这份文档要像宪法:短、稳定、可引用、只增不改。细节外链到分层的文档里,什么放哪一层有判据;给审查者的入口是一份指针文件,不双份维护;文档与代码的一致性要有规则背书,而不是靠自觉。
每个新会话都从零开始。实现 agent 打开仓库,第一件事是读仓库根目录的 CLAUDE.md;审查 agent 读的是 AGENTS.md。这两份文档里写的东西,就是 agent 在这个项目里的全部先验。
这意味着一件事:文档的质量直接等于 agent 行为的质量。写得含糊,agent 就会用自己的判断补上——第 08 章讲过,那叫「自己加戏」。写得太长,agent 会跳过重点。写在错的地方,agent 根本读不到。
Agent X-Ray 的 CLAUDE.md 在项目第一天就有了,之后每一轮都在改,但它的结构从第一天起就没变过。
CLAUDE.md 开头有一行注释:「本文只留五块:项目定位、仓库结构、开发模式与轮次流程、硬性规则、本地开发与部署。架构 / 安全 / 部署细节都在 docs/,轮次拆解在仓库根 ROUNDS.md,按需读。」
| 块 | 回答的问题 | 长度 |
|---|---|---|
| 项目定位 | 这是什么、给谁用、功能边界在哪、当前处于什么阶段 | 一段 |
| 仓库结构 | 每个顶层目录是什么角色、哪些是生成物、哪些刻意放在框架根之外 | 一张树 |
| 开发模式与轮次流程 | 谁开发谁审查、一轮怎么跑、审查范围与收口标准、审查边界 | 七行流程 + 几条裁定 |
| 硬性规则 | 编号 1–13,每条带「为什么」 | 全文最长的一块 |
| 本地开发与部署 | 唯一入口的命令、管理面怎么连、环境矩阵 | 一张命令表 + 几张对照表 |
五块的顺序也有讲究:先说这是什么,再说东西在哪,再说怎么工作,再说什么不能做,最后是怎么跑起来。agent 按顺序读,读到规则的时候已经知道规则在约束什么。
其它一切都外链。CLAUDE.md 里出现最多的句式是「详见 docs/xxx.md」——它是入口,不是全集。
CLAUDE.md 的硬性规则段开头一句:「编号只增不改。」注释里解释了原因:代码注释会引用「规则 N」,重排会让所有引用失效;删掉的规则留「已废弃」占位。
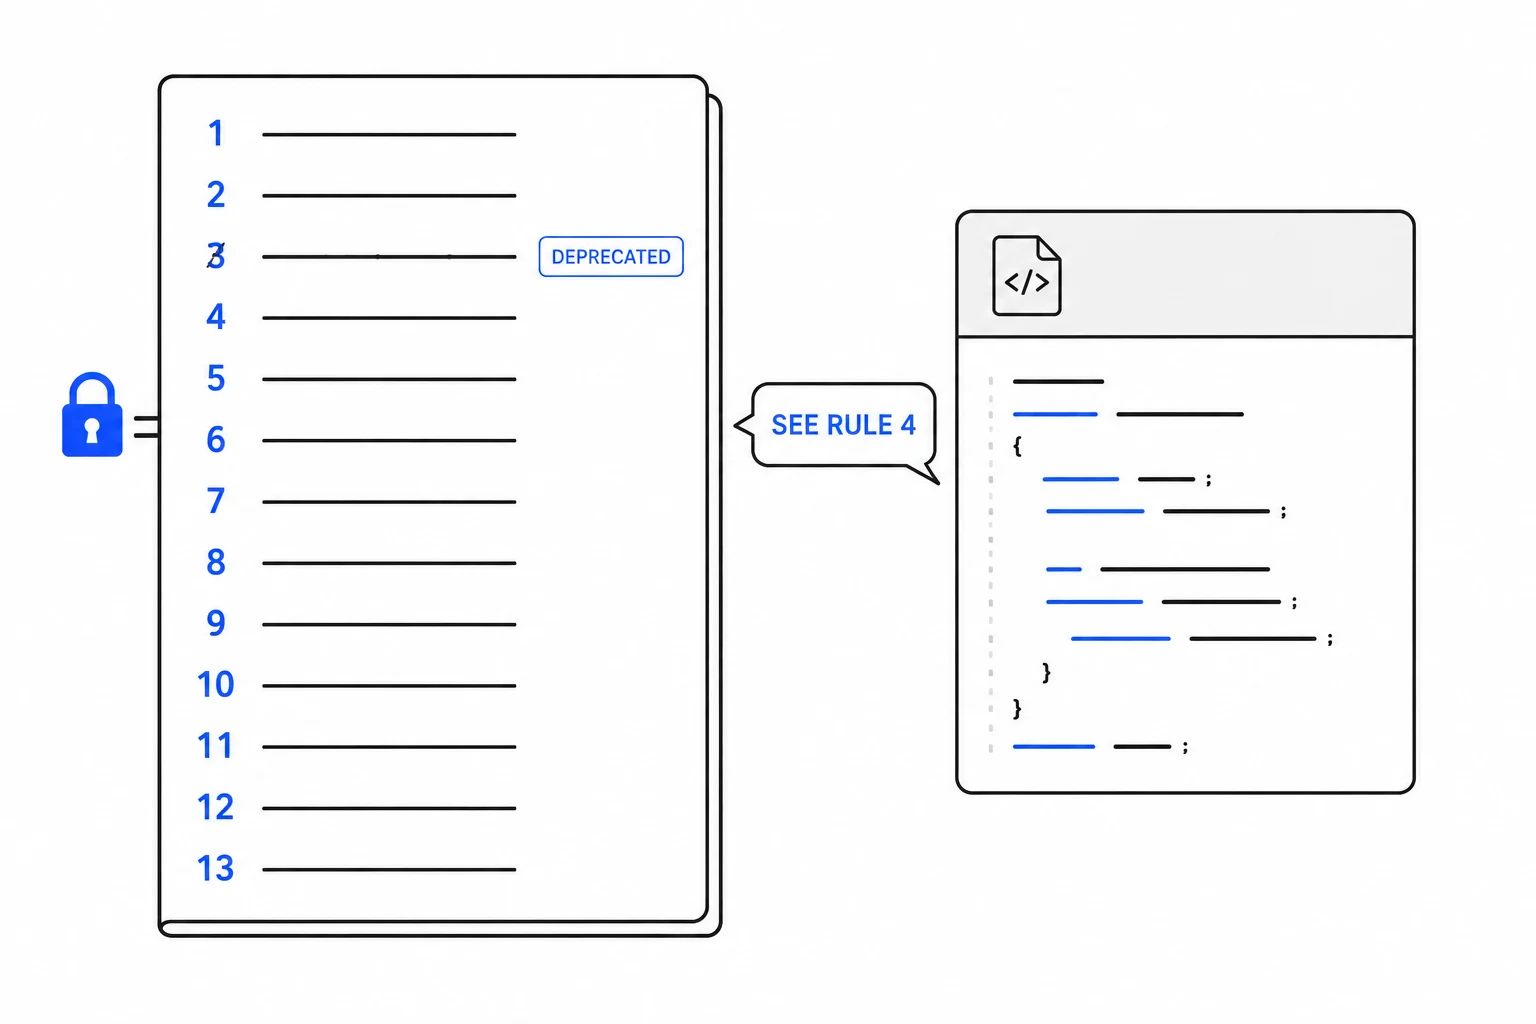
编号锁死,废弃的留占位;代码注释里的「见规则 4」在半年后仍然指向同一条。
十三条规则的来历本身就是一份教材:
规则 1–4 是继承来的。 它们「继承自上一个项目同机踩过的坑,原样适用」:encore 命令必须走 dev.ps1(守护进程的 socket 绑不到含中文的路径);测试只能经框架的测试命令跑(裸跑会缺环境变量);含中文的 PowerShell 脚本必须带 BOM(否则参数行会被当注释吞掉);写 JSONB 的固定写法(否则库里存成字符串标量,查询全部失效)。每条都是「命令看着成功、结果是错的」那一类,不写下来一定会再撞一次。
规则 8 是长出来的。 第一天只有一句「严禁实现设计稿没有的功能」。之后每次边界变化都在它下面加一个带日期的子条目:R-TOOLS 加工具面板(先改画板再进轮次)、R-TABS 加呈现开关(是例外,理由是合规运维动作)、R-SKILLS 加技能库(先改画板)、R-SKILLS-2 让 agent 使用 skills、R-WEBFETCH 读网页、R-PERF 加载态与错误态(先改画板)、R-TOOLCARDS 工具调用卡。七个子条目,每个写清是不是例外、为什么。规则本身没变,它的适用记录在生长。
规则 9 是改过措辞的。 原文写「业务工具必须纯函数」,与安全文档第四层的「外呼型工具」自相矛盾。R-WEBSEARCH 时改成「工具分两组」,之后变成三组、四组。改措辞时把原文和改的理由都留在了规则里——读者能看到它是怎么变过来的。
规则 11、12 是投产后加的。 生产 JS 运行时统一为 bun,且「开实验位」与「换基座」必须成对出现(只开一个会产出必然启动失败的镜像);生产两条硬约束被升级破坏时必须提前告知所有者。它们是被真实的坑逼出来的,写进去的同时附带了判据(别用某个命令去验,要用另一个)。
规则 13 是最新的。 管理面工具变动必须同步更新契约文档,工具总数在任务卡与提交里显式核对。
每条规则的形状都一样:规则本身 + 为什么 + 违反时的表现 + 判据。只有规则没有为什么,agent 会在边界情况下猜;只有为什么没有判据,agent 会用错误的方法验证。
CLAUDE.md 是入口,不是全部。项目里的文档分六层,每层有明确的放置判据:
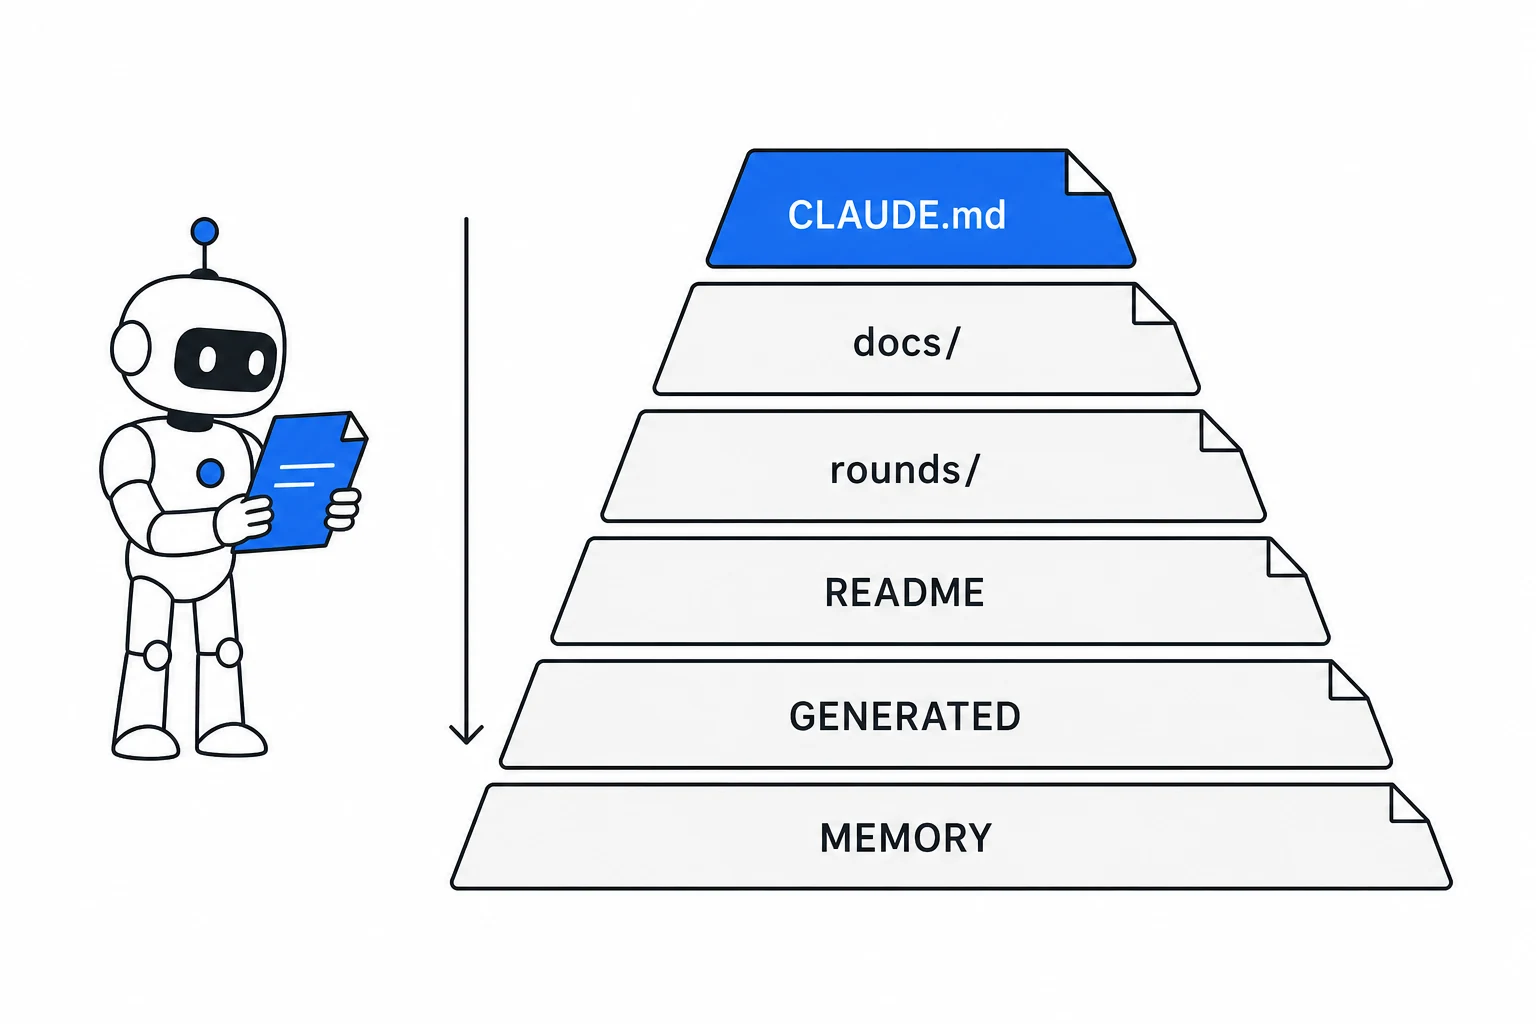
从上往下读:宪法、约束、轮次、服务边界、生成物、记忆。越往下越具体、越易变。
| 层 | 内容 | 放置判据 |
|---|---|---|
| CLAUDE.md | 定位、结构、流程、规则、入口 | 每个会话都必须知道的;改动频率低 |
| docs/ | 架构决策、安全模型、部署矩阵、管理面契约、发布记录 | 强约束与既定决策;改动要先于代码 |
| ROUNDS.md / rounds/ | roadmap、任务卡、BACKLOG | 轮次级的目标、验收、裁定、实测 |
| 每服务 README.md | 服务边界、容易改错的地方 | 只与这个服务有关的事实 |
| 生成物 | 客户端类型、skills 清单 | 入库、不许手改、由构建命令生成 |
| 用户级 CLAUDE.md 与项目记忆 | 本机环境坑、所有者纠正、操作事实 | 仓库不该记的东西(跨项目的、与本机有关的、与会话有关的) |
三条判据决定一样东西放哪:
生成物那一层值得单说。apps/web/lib/api-client.ts 由构建命令从后端类型生成,apps/api/shared/skills.generated.ts 由清单生成器从 skill 目录生成。它们入库(让审查者能看到 diff),但不许手改(改了下次生成就丢)。文件头写着这句话,CLAUDE.md 规则 6 也写着。
审查 agent 读的入口不同。AGENTS.md 全文只有十几行:第一句是「本仓库的全部开发约定、硬性规则与轮次流程见 CLAUDE.md,请以其为准(本文件只是指针,避免双份维护)」。
下面是「审查者速记」——把审查者最需要知道的判据压成几条:
速记不复述规则内容,只告诉审查者「什么算严重」。审查者需要的是判据,不是教程。
不双份维护是关键。项目里曾经考虑过给审查者单独写一份完整文档,最后否决了:两份文档一定会分叉,分叉之后实现者和审查者依据的规则就不一样了。
文档最常见的失败是过期。项目里用三种机制对抗它。
规则背书。 规则 13 要求管理面工具变动必须同步契约文档,工具总数在任务卡与提交里显式核对。规则 9 要求安全边界的改动先改文档。这些不是「建议保持同步」,是审查者会判阻断级的硬规则。
计数一致性。 设计稿的画板数量在三处出现:design/README.md、CLAUDE.md 规则 8、ROUNDS.md 功能边界。每次拉新画板都要三处一起改,漏一处就自相矛盾。管理面工具总数在 docs/mcp.md 与发版冒烟里都要核对(28 → 34 → 42 → 46)。计数是最便宜的一致性检查——数字对不上,一眼就能看见。
以实测为准回改。 架构文档里的事件计数原来写着合计 33,R1 实测是 34,文档按实测回改并附了逐事件清单的指针。文档不是「设计时想的」,是「实测是什么」。
每服务的 README.md 也在这个体系里:CLAUDE.md 明确说「服务清单与各自边界以各服务 README 为准,本文不再逐服务记状态」。管理面的 README 里有一节「三条容易改错的地方」,专门记那些看起来对、实际错的用法——协议请求的命名空间前缀少一个键,处理器会静默落到旧协议路径,工具列表照常通而发现接口报「方法不存在」,看起来像端点坏了,其实是请求走错了协议时代。
几条从项目文档里总结出来的写法:
判据比描述重要。 「镜像里不含 node」是描述;「用某个命令去验会得出错误结论,因为基座自带一个指向 bun 的软链;正确判据是三条」是判据。agent 拿到判据才能验证,拿到描述只能相信。
写「表现」。 每条坑都写清「漏了会怎样」:漏补服务白名单的表现是该服务端点静默 404;漏同步 skills 镜像的表现是审查悄悄退回旧清单;协议请求少一个键的表现是发现接口报方法不存在。agent 遇到那个表现时,能反查到原因。
写「为什么」。 规则 4 为什么要用那种 JSONB 写法,规则 11 为什么实验位和基座必须成对——为什么写清楚了,agent 在规则没覆盖到的边界情况下才能推断出正确做法。
写日期与来源。 每条裁定带日期与轮次代号,每次修订带「所有者裁定」。半年后读的人能判断这条还适不适用。
别写可推导的。 目录里有什么文件、函数叫什么,agent 自己会看。
文档太长,agent 不读重点。 五块结构与「细节外链」就是为了这个。
规则重排。 插一条新规则到中间,后面全部改号,代码注释里的引用全部失效。
双份维护。 给不同的 agent 写不同的文档,分叉之后规则不一致。
把「设计时想的」当事实。 事件计数 33 那种笔误,要靠实测回改。
把纠正留在对话里。 所有者说过「别这样做」,下个会话又做了一次。去处是记忆文件,第 20 章讲。
为自己的项目写一份五块结构的 CLAUDE.md:定位一段、结构一张树、流程七行、规则从 1 开始编号、入口一张命令表。每条规则写三样东西:规则本身、为什么、违反时的表现。写完数一数字数,超过一屏的部分考虑外链。
 苏公网安备32011402012723号