核心观点 agent 的上下文不是越多越好,而是要设计「什么在哪一层、什么时候进上下文」。记忆分四层,各有放置判据;记忆条目要写现象、原因、可靠做法、判据;环境是第一个要工程化的对象,那些「命令看着成功、结果是错的」坑要有唯一入口挡在前面;含凭据的东西和大文件不经上下文转手。
第 03 章讲过:模型的上下文容量不等于有效理解容量。无关内容、重复规则、相互冲突的文档会稀释关键信号。对一个跨会话工作的 agent 来说,还有一个更基本的事实:它没有跨会话的记忆。每个新会话都从零开始读仓库。
这意味着「上次踩过的坑」「所有者说过不要这样做」「那个验证脚本怎么写的」,如果只存在于上一个会话的对话里,下一个会话就不知道。而如果把所有东西都塞进 agent 每次都读的文档,它会被淹没。
所以上下文要设计:什么东西放在哪一层,什么时候被读到,什么时候可以不读。
Agent X-Ray 的实践里,agent 能读到的东西分四层:
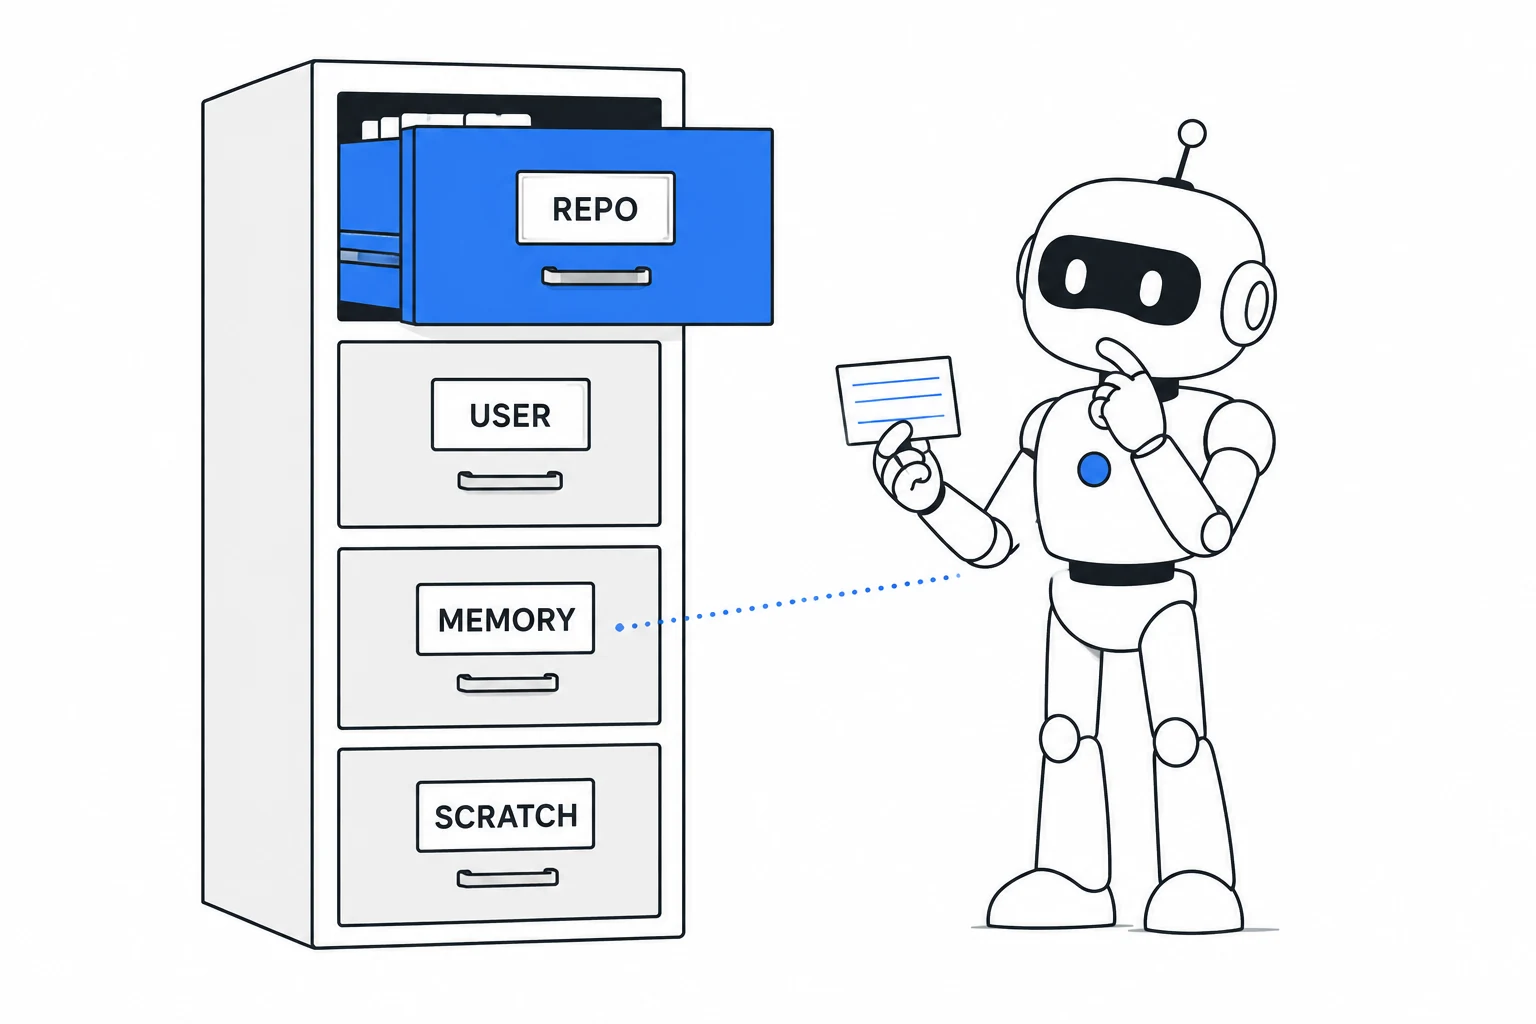
四个抽屉:仓库、用户级、项目记忆、会话临时。一张卡片该放哪个抽屉,有判据。
| 层 | 内容 | 谁读 | 放置判据 |
|---|---|---|---|
| 仓库 | CLAUDE.md、docs/、rounds/、各服务 README、生成物 | 每个会话、每个 agent | 可推导的事实、既定决策、轮次记录——凡是「这个项目的」 |
| 用户级 | 用户级 CLAUDE.md「本机环境」段 | 这台机器上的每个项目 | 跨项目的本机坑:路径、守护进程、编码、行尾、沙箱 |
| 项目记忆 | 记忆目录里的一个个文件,加一份索引 | 这个项目的后续会话 | 仓库不该记的操作事实与所有者纠正 |
| 会话临时 | scratchpad 目录里的脚本、中间结果 | 只有本会话 | 一次性的东西;任务卡只记结论与路径 |
三条判据决定一样东西往哪放:
仓库能推导出来的不写进记忆。 代码结构、过去的修复、git 历史,agent 自己能查。记忆里写这些只会过期。
跨项目的提升到用户级。 项目记忆里曾经记着「含中文的用户名路径会让守护进程的 socket 绑不上」「含中文的脚本必须带 BOM」这类坑。它们不是这个项目的事实,是这台机器的事实。2026-09-03 把它们整体提升到用户级 CLAUDE.md,项目记忆里删掉,索引里留一行「已提升,不再重记」。
与会话有关的不入库。 验收用的假 provider 脚本、图片转换脚本、探测请求脚本,都放会话临时目录。任务卡写「脚本留档在会话 scratchpad,不进仓库」。
项目记忆是一个个独立文件,每个文件一件事,带一行描述用于判断相关性,正文有固定的形状。几条实例:
「审查循环不是设计」(所有者纠正)。正文先讲现象:七轮审查里第 2 到第 6 轮的 findings 全部落在自建的消毒器上;再讲为什么错:把「每条 findings 都能最小改动闭合」误当成「可以继续循环」的理由;然后是怎么应用:判据是连续两轮 findings 落在同一处且那一处是任务卡里没有的自建机制,停;停下后把边界说成一句话,找不需要理解输入结构的办法,列选项让所有者裁定。
「审查收口之后才构建镜像」(所有者纠正)。现象:审查还没出结果就后台发起了构建。为什么:镜像 tag 是 SHA,审查要整改 SHA 就变。怎么应用:构建、发版、起容器验证镜像都放在审查清零、分支合并之后;同一条 findings 指向一类模式时按模式修不按行修。
「审查任务脱离启动」(操作事实)。现象:后台发起的审查读完 diff 后 38 分钟零日志。原因:审查进程随启动器退出。可靠做法:换一种启动方式,把结果写到文件,用监视器轮询。判据:先看有没有心跳输出再下结论。附带耗时基线。
「发 skill 前先看 LICENSE」(项目事实)。判据是 skill 目录内的许可文件,不是它所在仓库是否公开;「上游原版」要 diff 过才算;公开前要洗的资产清单;grep 要不区分大小写并且扫目录名。
四条的共同形状:现象 → 原因 → 可靠做法 → 判据。所有者纠正类的条目多两段:为什么错与怎么应用。条目之间互相链接;过期就删;索引文件只放一行指针,正文不放索引里。
写记忆的时机是被纠正的当下,不是会话结束时。会话结束时很多细节已经忘了。
一个新会话开工,头十分钟最容易撞上的不是代码问题,是环境问题——而且是那种「命令看着成功、结果是错的」问题。项目里积累的清单:
每一条都会在头十分钟里制造「像是代码坏了」的假象。它们的去处有两个:跨项目的进用户级 CLAUDE.md,项目特有的进项目记忆或 CLAUDE.md 硬性规则(规则 1–4 就是这么来的)。
比记录更好的办法是堵在前面:
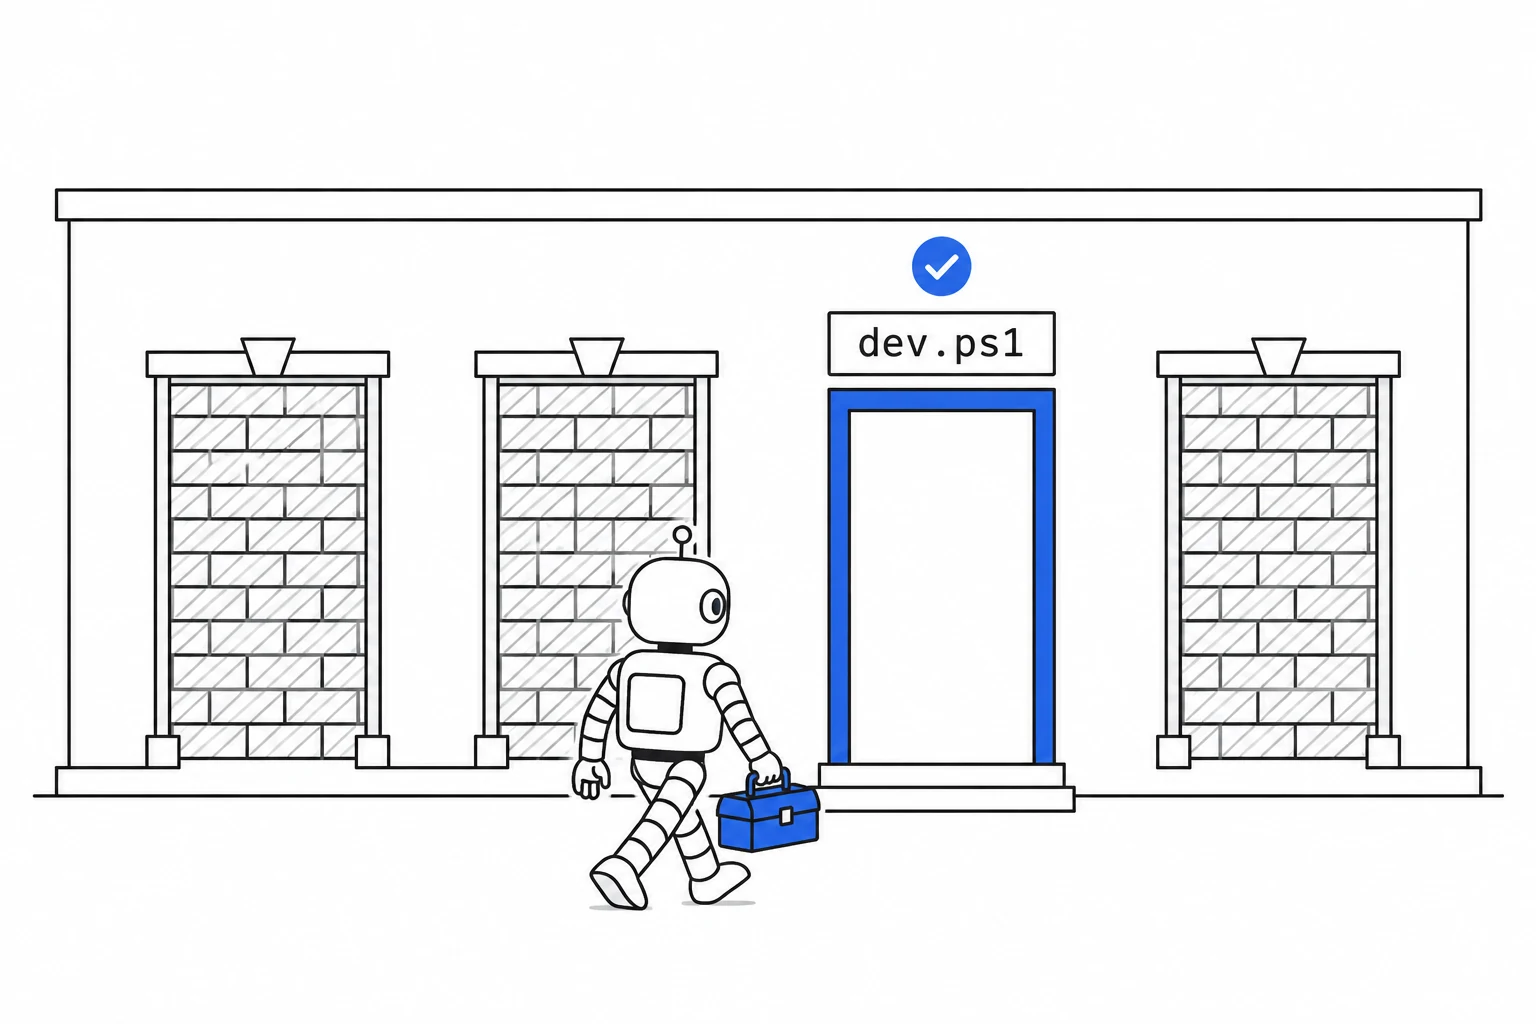
别的门都砌上了,只留一扇:所有本机的开发、测试、构建、发版动作都从这里进。
dev.ps1 是本机所有框架命令的唯一入口(规则 1)。它把正确的环境变量、路径、参数封装在一起:开发运行、测试、编译检查、生成客户端、构建镜像、发版、同步 skills、清理工作树。agent 不需要知道守护进程的 socket 该绑在哪——它只需要知道「跑 dev.ps1 test」。
唯一入口还能做校验:脏工作区拒绝构建;运行时版本漂移告警;构建前检查 skill 清单与目录一致。这些校验是那些坑的物理落点。
agent 的知识不只来自项目文档,还来自 skills——按领域打包的操作指南。项目里有几条口径:
skills 是上下文的一部分,也要有版本、有同步、有退役。
有些东西不该进上下文,有些东西进了会把上下文塞爆:
含凭据的调用走脚本从文件读。 管理面写 provider 要带 key。做法是脚本从文件读 key 再发请求,key 不出现在命令文本(会进进程列表),不出现在对话上下文。所有者要求「不进上下文」时,连读文件的工具都不用——在脚本里读。
批量内容走脚本直连。 发 22 篇章节,走脚本直连端点 5.7 秒;走工具逐篇调用,正文会把上下文塞爆。
大文件从持久化结果提取。 工具返回的大结果会被持久化到文件;从那里用脚本提取到磁盘,不经写入工具重写——省几万 token,也避免转义被解码。
写正则的转义陷阱。 写入工具会把某种 JSON 风格的转义序列解码成字面控制字符,文件从此被判成二进制、编辑工具再也匹配不上那一行。含这类转义的内容用脚本按行写回,改完扫一遍控制字符。
图片二进制不经上下文。 生成的图片保存到磁盘,转换、哈希、入库都由脚本做;上下文里只有路径与哈希。
实现 agent、审查 agent、设计 agent 各有各的入口,但真相只有一份:
两个 agent 依据不同版本的规则工作,比没有规则更糟——它们会各自「正确」地产出互相矛盾的东西。
纠正留在对话里。 下个会话再犯,所有者再纠正一次。
什么都写进 CLAUDE.md。 agent 被淹没,重点被跳过。
环境坑每次重踩。 没有唯一入口,每个会话前十分钟都在排查「像代码坏了」的问题。
凭据进上下文。 一次 cat 就把 key 带进了对话记录。
skills 漏同步。 审查悄悄变弱。
把自己最近踩的三个「看着成功、结果是错的」坑写成记忆条目:现象、原因、可靠做法、判据。然后判断每一条该放哪一层——仓库、用户级、项目记忆——并检查有没有一条其实可以变成唯一入口里的一行校验。
 苏公网安备32011402012723号